Tháng 8/2026, Yellow Web so sánh 5 công cụ spy quảng cáo — các nền tảng thu thập quảng cáo từ mạng xã hội và cho phép tìm kiếm trong kho dữ liệu đó. Cả năm dịch vụ nhận cùng một nhiệm vụ: tìm quảng cáo iGaming (casino trực tuyến, cá cược, xổ số) tại Tây Ban Nha trong ngày 1 tháng 8 và tuần từ 26 tháng 7 đến 1 tháng 8; lấy 100 quảng cáo đầu tiên của mỗi khoảng thời gian rồi so sánh kết quả từ Spytrend, Tyver, AdWall, Gamler và MTWSPY. Một AI agent thực hiện nhiệm vụ này. Tác giả công khai bộ công cụ để người khác có thể lặp lại bài thử. Bài thử gốc — “Năm công cụ spy dưới góc nhìn của AI agent”
Chúng tôi là đội ngũ Spytrend, một trong 5 dịch vụ được thử nghiệm. Chúng tôi lấy đúng các mẫu quảng cáo đó, chạy lại cùng truy vấn và công bố dữ liệu của cả hai lần chạy: kết quả agent thu được trong bài thử và kết quả khi bật các bộ lọc tiêu chuẩn của dịch vụ. Có những con số chúng tôi xác nhận nguyên vẹn. Những chênh lệch còn lại không đến từ quy mô cơ sở dữ liệu mà từ cách agent truy vấn. Điều quan trọng nhất với người tìm kiếm bằng AI: kết quả phụ thuộc vào cách agent kết nối với dữ liệu, chứ không phải bản thân mô hình. Bạn có thể tự kiểm tra — mã kiểm chứng và dữ liệu thô của cả hai lần chạy đều được công khai.
Các dịch vụ được so sánh
- Spytrend (chúng tôi) — nền tảng phân tích quảng cáo đối thủ trên Facebook và TikTok: khoảng 1,8 tỷ quảng cáo, thêm khoảng 280 triệu quảng cáo mỗi tháng, phân loại theo 33 danh mục và 342 danh mục con, hỗ trợ kết nối AI agent chính thức. Gói Pro có giá 79 USD/tháng.
- Tyver — công cụ spy phân loại theo một vài nhóm ngành lớn và cho phép sắp xếp kết quả theo lượt xem; trong bài thử, dịch vụ trả về 11.497 quảng cáo cho cả tuần.
- AdWall — công cụ spy cho dùng miễn phí 30 ngày; trong bài thử, dịch vụ trả về 16.369 quảng cáo cho cả tuần, nhưng 73 trong 100 tệp đầu tiên không đúng chủ đề.
- Gamler — dịch vụ chuyên biệt có hệ thống phân loại và bộ đếm số lần chạy lại creative riêng; là dịch vụ duy nhất không có quảng cáo lạc chủ đề trong bài thử, nhưng lượng dữ liệu nhỏ hơn đáng kể.
- MTWSPY — dịch vụ chuyên biệt có hệ thống phân loại riêng và cho phép sắp xếp theo lượt xem; 13% kết quả theo tuần không đúng chủ đề.
Mô tả dịch vụ được đối chiếu với website của họ tính đến tháng 9/2026 (Tyver, AdWall, Gamler, MTWSPY); các số liệu lấy từ bài thử của Yellow Web (tháng 8/2026).
- Tác giả — tác giả bài viết trên Yellow Web, người thiết kế và thực hiện bài thử.
- Agent — AI agent được tác giả giao nhiệm vụ thay vì tự tìm kiếm: chương trình gửi yêu cầu tới cả 5 dịch vụ và tổng hợp kết quả.
- Lớp trung gian — công cụ dòng lệnh do tác giả tự viết, nằm giữa agent và các dịch vụ: nó nhận lệnh của agent rồi chuyển thành yêu cầu gửi đi. Những gì lớp này không chuyển tiếp thì agent không thể thấy.
- Kết quả đo — những con số agent thu được trong bài thử.
- Lần chạy lại — cùng truy vấn được chúng tôi chạy lại trên cùng dữ liệu, nhưng dùng thiết lập tiêu chuẩn của dịch vụ.
- Thiết lập tiêu chuẩn — cách dịch vụ hoạt động khi bật những bộ lọc chưa được bật trong bài thử.
- Các mẫu quảng cáo của tác giả — chính những quảng cáo agent thu thập trong bài thử. Chúng tôi dùng đúng các mẫu này để số liệu có thể đối chiếu.
Cách chúng tôi kiểm tra lại
Một phép đo đáng tin cậy phải có khả năng tái lập. Chúng tôi chạy cùng truy vấn trên đúng các mẫu quảng cáo của tác giả: khi điều kiện giống nhau, chúng tôi giữ nguyên số liệu của tác giả; khi điều kiện khác thiết lập tiêu chuẩn, chúng tôi đặt hai kết quả cạnh nhau và nói rõ đã thay đổi gì. Mỗi mục dưới đây đều theo trình tự: bài thử ghi nhận gì → vì sao có kết quả đó → lần chạy lại cho ra gì.
Những điều lần kiểm tra này không chứng minh được.
- Bài thử so sánh 100 kết quả đầu tiên — tương đương 3,2% lượng quảng cáo theo ngày và 0,4% theo tuần của chúng tôi. Không thể dùng mẫu đó để kết luận hai cơ sở dữ liệu trùng nhau đến mức nào.
- Tỷ lệ quảng cáo đúng chủ đề được tác giả đo trên 100 mẫu, sau đó ngoại suy cho toàn bộ dữ liệu dưới dạng ước tính.
Tóm tắt
Ba trong 6 điểm chênh lệch bắt nguồn từ cách agent truy vấn dịch vụ, không phải dữ liệu trong cơ sở dữ liệu. Chúng tôi xác nhận nguyên mức sử dụng hạn mức; còn bảng đối chiếu tính năng tìm kiếm của chính bài thử cho thấy Spytrend có lợi thế.
- Lượng kết quả. Agent lấy ra 996 quảng cáo từ Spytrend cho ngày 1 tháng 8 và 9.526 quảng cáo cho cả tuần. Với cùng truy vấn, cơ sở dữ liệu khi đó có 3.112 và 24.985 quảng cáo. → xem chi tiết
- Quảng cáo trùng lặp. Bài thử không bật công tắc “Chỉ mẫu duy nhất” (Only Unique) — bộ lọc gộp mọi bản sao của cùng một creative (ảnh hoặc video dùng trong quảng cáo) thành một dòng. Vì vậy, trong 100 mẫu chỉ có 55 tệp khác nhau. Bật bộ lọc trên cùng dữ liệu sẽ cho 100 creative khác nhau trong 100 kết quả. → xem chi tiết
- Kết nối AI agent. Trong bài thử, máy chủ MCP (Model Context Protocol, giao thức chính thức để kết nối trực tiếp AI agent với dịch vụ) của chúng tôi được ghi nhận 0/8 lệnh gọi thành công, thời gian phản hồi trung bình khoảng 179 giây. Nhật ký máy chủ cho phiên của tác giả ngày 3 tháng 8 lại ghi nhận 43/43 lệnh gọi thành công, không lỗi, trung bình 1,6 giây. Chênh lệch nằm ở lớp trung gian tác giả tự viết: nó khởi tạo phiên agent mới cho mỗi yêu cầu. → xem chi tiết
- Khả năng tìm kiếm. Trong bài thử của Yellow Web (tháng 8/2026), chỉ Spytrend được ghi nhận có tìm kiếm theo độ tương đồng hình ảnh của creative và theo Facebook pixel (mã theo dõi nhà quảng cáo gắn trên website). Bảng so sánh không đề cập đến tìm kiếm theo một phần liên kết theo dõi hoặc truy vết mạng lưới của một webmaster — các domain, trang và pixel thuộc cùng một bên chạy quảng cáo. → xem chi tiết
- Chi phí bài thử. Toàn bộ bài thử dùng 201 token — đơn vị hạn mức nội bộ của Spytrend, không phải token của mô hình ngôn ngữ. So với hạn mức 40.000 token mỗi tháng của gói Pro, con số này bằng khoảng nửa phần trăm. → xem chi tiết
- Bộ lọc quốc gia. Gần ba phần tư kết quả lọc theo Tây Ban Nha là quảng cáo chạy ở nhiều quốc gia, trong đó có Tây Ban Nha. Agent của tác giả tính những mẫu này là sai, dù chúng phù hợp với bộ lọc. Trong kết quả mới cho cùng lát cắt dữ liệu, không có mẫu lọc sai.
Cảm ơn tác giả Yellow Web vì bài thử kỹ lưỡng và bộ công cụ công khai. Dưới đây là cả 8 điểm: bài thử ghi nhận gì, vì sao có kết quả đó và lần chạy lại với thiết lập tiêu chuẩn cho ra gì.
5 kết luận chính của bài thử — và kết quả kiểm tra lại
| Kết luận trong bài thử | Kết quả kiểm tra lại |
|---|---|
| MCP không hoạt động: 0/8 | 43/43 lệnh gọi thành công, trung bình 1,6 giây → mục 6 |
| 100 kết quả chỉ có 55 tệp khác nhau | Giữ cách sắp xếp cũ: vẫn là 55; bật “Chỉ mẫu duy nhất”: 100/100 → mục 4 |
| Các cơ sở dữ liệu gần như không trùng nhau | Thứ được so sánh là 100 kết quả đầu tiên — 0,4% lượng dữ liệu theo tuần, không phải toàn bộ cơ sở dữ liệu → mục 5 |
| 996 quảng cáo trong một ngày | Đó là số agent lấy ra; cơ sở dữ liệu có 3.112 quảng cáo → mục 2 |
| Thiếu 5 mục trong bảng bộ lọc | Hai ô bị đánh dấu thiếu nhầm; trong bài thử (tháng 8/2026), chỉ Spytrend được ghi nhận có tìm kiếm theo độ tương đồng hình ảnh và theo pixel → mục 1 |
8 điểm gây tranh luận trong bài thử và kết quả kiểm tra lại
| 1. Bộ lọc và tìm kiếm creative | Trong bài thử (tháng 8/2026), chỉ Spytrend được ghi nhận có tìm kiếm theo độ tương đồng hình ảnh của creative và theo pixel |
| 2. Lượng dữ liệu trong cùng khoảng thời gian | 996 là số quảng cáo agent lấy ra; cơ sở dữ liệu có 3.112 |
| 3. Mức độ đúng chủ đề của kết quả | 96% đúng chủ đề theo phép đo của chính tác giả |
| 4. 100 creative không trùng lặp | Kết quả trùng lặp do thiết lập thu thập, không phải do bản thân cơ sở dữ liệu |
| 5. Mức độ trùng nhau giữa các cơ sở dữ liệu | Không thể đo từ 100 kết quả đầu tiên |
| 6. Kết nối AI agent | Cùng một máy chủ của chúng tôi xuất hiện hai lần trong bảng thử nghiệm dưới hai tên khác nhau |
| 7. Mức sử dụng hạn mức | 201 token, bằng khoảng nửa phần trăm hạn mức tháng |
| 8. Giá trị với media buyer | Lượng quảng cáo đúng chủ đề theo tuần nhiều hơn 4 dịch vụ còn lại cộng lại |
Điểm mạnh của phương pháp
Bài thử được thực hiện thế nào — và phương pháp đã làm đúng những gì
Một bài so sánh công khai 5 dịch vụ trên cùng một nhiệm vụ không thường gặp, và bài thử này được thực hiện cẩn thận hơn phần lớn bài đánh giá trong lĩnh vực.
Thiết kế bài thử: gửi cùng một truy vấn — quảng cáo iGaming tại Tây Ban Nha — đến cả 5 dịch vụ, trong hai khoảng thời gian: ngày 1 tháng 8 và tuần từ 26 tháng 7 đến 1 tháng 8. Với mỗi dịch vụ, agent lấy 100 mẫu đầu tiên cho từng khoảng, tải tệp ảnh và video, xem hết những quảng cáo còn nghi vấn để xác định có đúng chủ đề không, rồi dùng hai loại mã băm để đếm tệp trùng giữa các dịch vụ. Những điểm phương pháp này đã làm đúng:
- Dùng hai loại mã băm thay vì một. Các tệp trùng được xác định bằng SHA-256 — mã kiểm tra của tệp — và thêm PDQ, vPDQ, tức mã băm cảm nhận cho hình ảnh và video. Bước thứ hai phát hiện các bản sao bị nén lại hoặc cắt xén mà phép so sánh theo byte bỏ sót.
- Đếm riêng từng loại. Mẫu quảng cáo, tệp đã tải và các phiên bản hình ảnh của cùng một creative được đếm riêng. Chính nhờ vậy, bài thử cho thấy “100 mẫu quảng cáo” và “100 creative” là hai con số khác nhau.
- Xem hết các video còn nghi vấn. Tác giả kiểm tra mức độ liên quan bằng cách xem video, không dựa vào tên tệp hay nội dung chữ của quảng cáo. AI agent của tác giả xếp từng tệp duy nhất vào nhóm đúng chủ đề, không liên quan hoặc chưa rõ. Trong 100 mẫu theo tuần của chúng tôi, 4 tệp không đúng chủ đề — đó là nguồn gốc của tỷ lệ 4%: kết quả kiểm tra bằng cách xem nội dung, không phải phỏng đoán.
- Công khai công cụ và nêu đúng giới hạn. Tác giả công khai lớp trung gian tự viết giữa agent và các dịch vụ, đồng thời nói thẳng: “Bài thử này KHÔNG có dịch vụ thắng tuyệt đối, và điều đó hoàn toàn bình thường”. Thiết kế bài thử hợp lý: cùng truy vấn, cùng ngày, cùng một quốc gia cho cả 5 dịch vụ. Nhờ vậy, kết quả có thể được tính lại — và đó là việc chúng tôi đã làm. Phép tính lại cho ra bức tranh khác bảng tổng kết cuối bài thử.
Những gì đã được xác nhận
Những kết quả của bài thử được tái lập
Trước tiên là các kết quả chúng tôi chạy lại và thu được đúng cùng con số. Đây không phải những lời giải thích để né tránh phản biện, mà là các kết quả có thể tái lập.
- Quảng cáo đa quốc gia trong kết quả. Một quảng cáo thường chạy ở nhiều nước cùng lúc, trong đó có Tây Ban Nha. Agent của tác giả tính những mẫu như vậy là không dành cho Tây Ban Nha. Trong kết quả mới cho cùng lát cắt dữ liệu, không có mẫu lọc sai.
- 100 kết quả có 55 tệp khác nhau là đúng khi sắp xếp theo lượt xem, cũng là cách agent lấy kết quả. Trên các mẫu của tác giả, chúng tôi thu được đúng 55 tệp cho cả tuần và 87 tệp cho một ngày. Bài thử không bật bộ lọc “Chỉ mẫu duy nhất”; khi không bật, kết quả đúng là như vậy.
- Bài thử tốn nhiều hạn mức hơn. Spytrend dùng 201 đơn vị, so với 42 của Tyver. Khi đó, chúng tôi tính hạn mức cho việc tải tệp ảnh và video; agent đã tải 200 tệp.
- Kết quả có quảng cáo không liên quan. 4% mẫu theo tuần không đúng chủ đề — đây là số liệu từ việc gán nhãn trong chính bài thử: agent của tác giả đã xem từng tệp.
- Khi đi qua lớp trung gian tự viết, MCP thực sự không hoạt động. 8 lệnh gọi, 8 lỗi. Nhật ký máy chủ cùng thời điểm ghi nhận gì sẽ được trình bày ở mục 6.
1. Bộ lọc và tìm kiếm
Hai ô trong bảng bị đánh dấu thiếu nhầm; các tính năng được xem là riêng của đối thủ đã có trên Spytrend khi thử nghiệm: từ một creative lần ra cả mạng lưới webmaster
“Tên các bộ lọc đôi khi tạo cảm giác rằng mọi dịch vụ dùng chung một tiêu chuẩn. Danh mục của Spytrend, nhóm ngành của Tyver và ngách của Gamler, MTWSPY đều dựa trên hệ thống phân loại riêng”.
Spytrend có 5 ô trống trong bảng tính năng. Tác giả đặc biệt nhắc đến cloaking, số lần chạy lại và khả năng tách gambling khỏi betting như những tính năng riêng của các đối thủ.
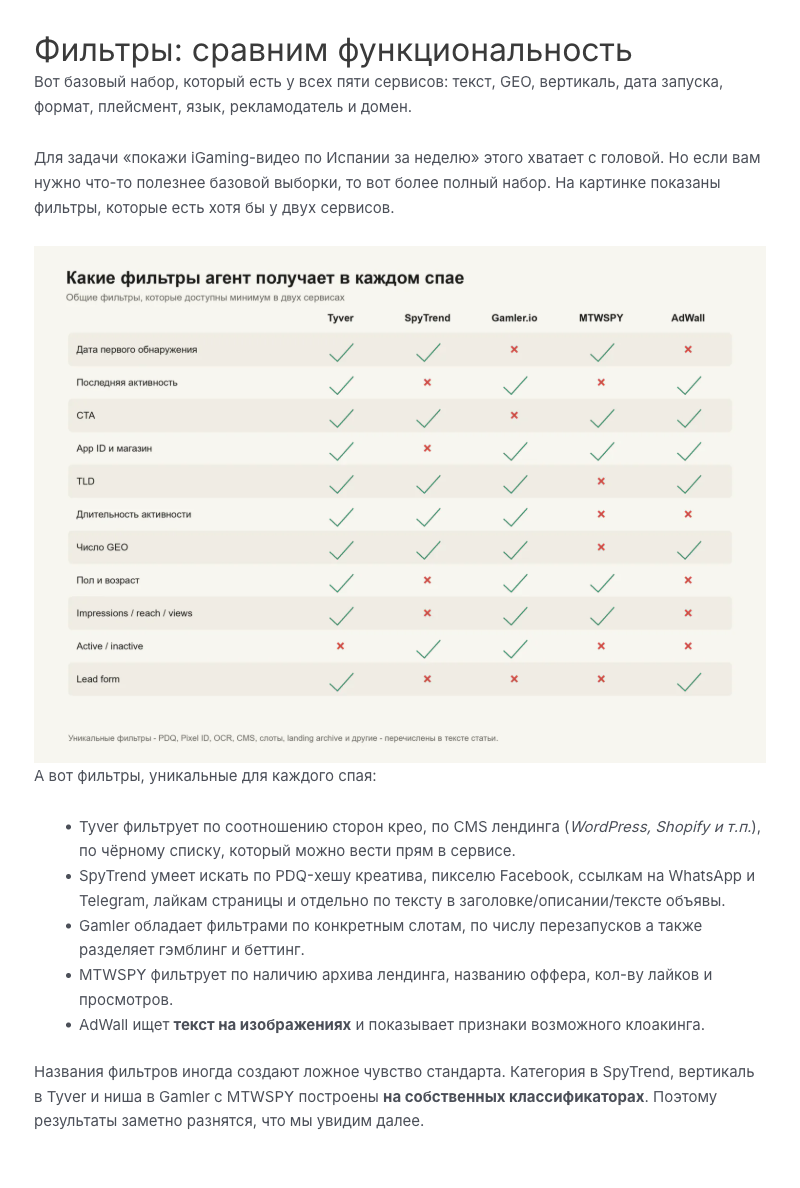
Kết quả đo ghi nhận gì. Trong bảng so sánh tính năng tìm kiếm, Spytrend có 5 ô trống: lần hoạt động gần nhất, App ID và cửa hàng ứng dụng, giới tính và độ tuổi, lượt hiển thị / phạm vi tiếp cận / lượt xem, biểu mẫu thu thập khách hàng tiềm năng. Còn cloaking, số lần chạy lại và khả năng tách gambling khỏi betting — những tính năng được nêu là điểm riêng của dịch vụ khác — cả ba đều đã có trên Spytrend khi thử nghiệm, chỉ mang tên khác. Cloaking là cách tráo trang đích; có thể tìm quảng cáo dạng này qua thẻ “Cloaking” (Cloaked) và công tắc “Chỉ quảng cáo cloak” (Cloaked ads only). Các lần chạy lại cùng một creative từ tài khoản khác được tìm bằng nút “Đăng lại nhiều nhất” (Most re-uploaded), với số lần chạy lại hiển thị ngay trên thẻ quảng cáo. Gambling và betting có thể được tìm riêng qua 8 danh mục con.
Vì sao có kết quả đó. Hai trong 5 ô trống bị đánh dấu nhầm: bộ lọc theo lần hoạt động gần nhất đã có khi thử nghiệm; tìm kiếm theo ứng dụng cũng vậy — một ô riêng nhận App ID, tên hoặc liên kết, bên cạnh là bộ chọn cửa hàng ứng dụng. Agent không thấy chúng vì cùng lý do không thấy “Chỉ mẫu duy nhất”: máy chủ cung cấp sơ đồ bộ lọc, nhưng lớp trung gian tự viết không chuyển tiếp phần này. Chúng tôi chủ động không đưa giới tính, độ tuổi và lượt hiển thị vào bộ lọc: Facebook coi hai chỉ số đầu là ước tính của họ và hoàn toàn không cung cấp lượt hiển thị cho quảng cáo thương mại. Spytrend thực sự không có bộ lọc quảng cáo dùng biểu mẫu thu thập khách hàng tiềm năng — ô này được đánh dấu đúng. Tám danh mục con về gambling và betting là: Online Casino Slots, Sportsbook, Crash and Plinko, Poker, Lottery, Esports Betting, Fantasy Sports, State Restricted Operators.
Những gì tác giả có ghi nhận và những gì không có trong bảng. Tác giả đã ghi nhận khả năng tìm theo độ tương đồng hình ảnh của creative và theo Facebook pixel — biểu đồ dưới đây cũng thể hiện điều đó. Nhưng bảng hoàn toàn bỏ qua hai tính năng: tìm theo một phần liên kết theo dõi và truy cập mạng lưới webmaster — từ một creative lần ra các domain, pixel và fan page (các trang Facebook dùng để chạy quảng cáo) của cùng một bên. Phần công việc này của media buyer không xuất hiện trong bảng so sánh.
Những hạn chế vẫn còn. Spytrend không có bộ lọc theo giới tính, độ tuổi và khoảng lượt hiển thị. Dữ liệu lượt hiển thị của quảng cáo thương mại có một vấn đề riêng; chúng tôi phân tích tại mục 4.
Xem trang đích thật phía sau lớp cloaking với giá 1 USD
Trước đây, cloaking khiến bạn chỉ thấy trang đích “trắng”, còn đối thủ thực sự đưa người dùng tới đâu thì không rõ. Giờ đây, trên thẻ creative trong mục “Quảng cáo” (Ads) có một nút để Spytrend tự truy cập phiên bản “đen” của trang, đi hết funnel qua từng lần chuyển hướng, cài và mở ứng dụng nếu funnel dẫn tới PWA hoặc APK (ứng dụng web hoặc tệp cài đặt Android), rồi xác định thương hiệu của bên vận hành — casino, nhà cái hay đơn vị khác.
Tài khoản của bạn sẽ nhận báo cáo về toàn bộ hành trình: ảnh chụp từng bước, các điểm chuyển đến và điểm cuối; bạn cũng có thể tải trang đích cần dùng thành một tệp lưu trữ. Cách khai thác trang đích của đối thủ được trình bày trong hướng dẫn về website và trang đích trên Spytrend. Giá là 1 USD cho mỗi lần chạy, áp dụng với mọi gói. Nếu không thành công, bạn được hoàn tiền.
2. Quy mô cơ sở dữ liệu
996 là số quảng cáo agent lấy ra, không phải tổng số trong cơ sở dữ liệu: ngày đó có 3.112 quảng cáo
“Spytrend, Tyver và AdWall có nhiều quảng cáo hơn đáng kể. Nhưng số lượng lớn tự nó chưa nói lên chất lượng”.
Biểu đồ ghi: Spytrend — 996 quảng cáo ngày 1 tháng 8 và 9.526 quảng cáo cho cả tuần.
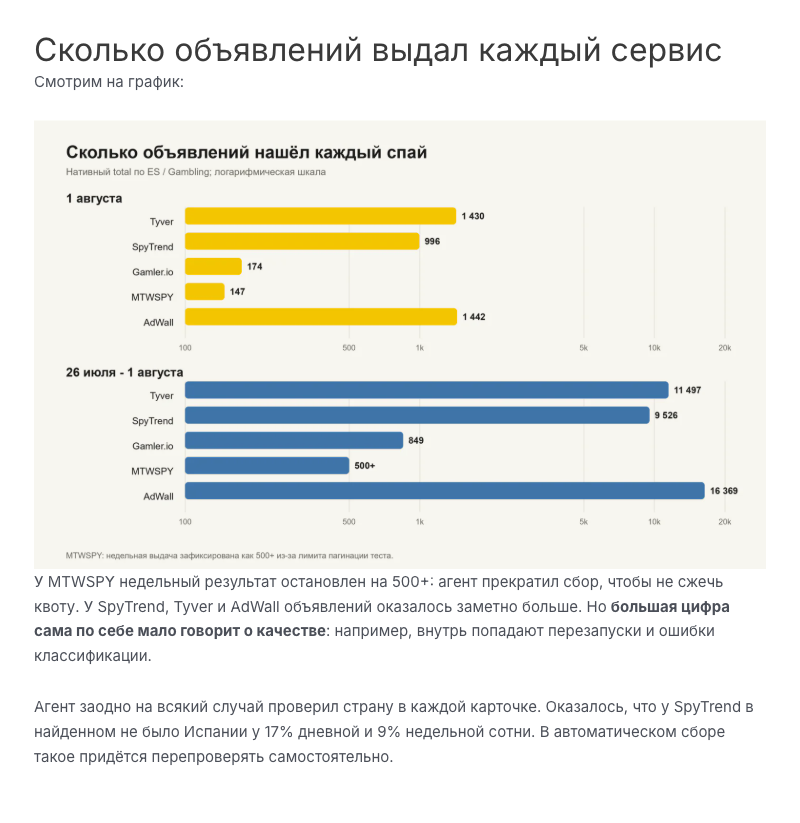
Kết quả đo ghi nhận gì. Agent lấy ra 996 quảng cáo từ Spytrend cho ngày 1 tháng 8 và 9.526 quảng cáo cho tuần từ 26 tháng 7 đến 1 tháng 8.
Vì sao có kết quả đó. Tại thời điểm thử nghiệm, cùng truy vấn này có 3.112 và 24.985 quảng cáo trong cơ sở dữ liệu. Chênh lệch không đến từ quy mô dữ liệu mà từ cách truy vấn. Việc thu thập dừng ở 100 mẫu cho mỗi khoảng thời gian, không lấy tiếp. Nhật ký máy chủ của chúng tôi không ghi nhận lỗi, yêu cầu bị từ chối hay hết hạn mức trong các lượt truy vấn đó.
Lần chạy lại. Chúng tôi liên tục bổ sung quảng cáo cho những ngày đã qua: khi tìm thấy fan page, domain hoặc mạng lưới webmaster mới, chúng tôi đưa các quảng cáo liên quan vào kết quả. Vì thế, dữ liệu của một tuần cũ vẫn có thể tăng thêm sau một tháng. Tại thời điểm đo ngày 11 tháng 9 năm 2026, cơ sở dữ liệu có 4.072 quảng cáo cho ngày 1 tháng 8 và 29.150 quảng cáo cho cả tuần đó.
Điều này giúp bạn thế nào. Giả sử một tháng trước bạn tìm được một tổ hợp đang chạy hiệu quả — creative, trang và domain mà đối thủ đang scale. Khi quay lại xem, bạn có thể thấy những quảng cáo và mối liên hệ mới đã được bổ sung cho chính giai đoạn đó, từ đó lần ra cách đối thủ triển khai và scale.
3. Mức độ đúng chủ đề
96% kết quả theo tuần của Spytrend đúng chủ đề iGaming — theo phép đo của chính tác giả
“Mẫu theo ngày của Spytrend và MTWSPY cũng không có quảng cáo lạc chủ đề. Trong cả tuần, MTWSPY có 13% kết quả không liên quan, còn Spytrend là 4%”.
“Với Tyver, chất lượng phụ thuộc nhiều vào khoảng thời gian và cách sắp xếp. Một ngày chỉ có 3% kết quả không liên quan, nhưng cả tuần lên tới 44%”. “AdWall trả về 73 tệp không liên quan trong 100 tệp”.
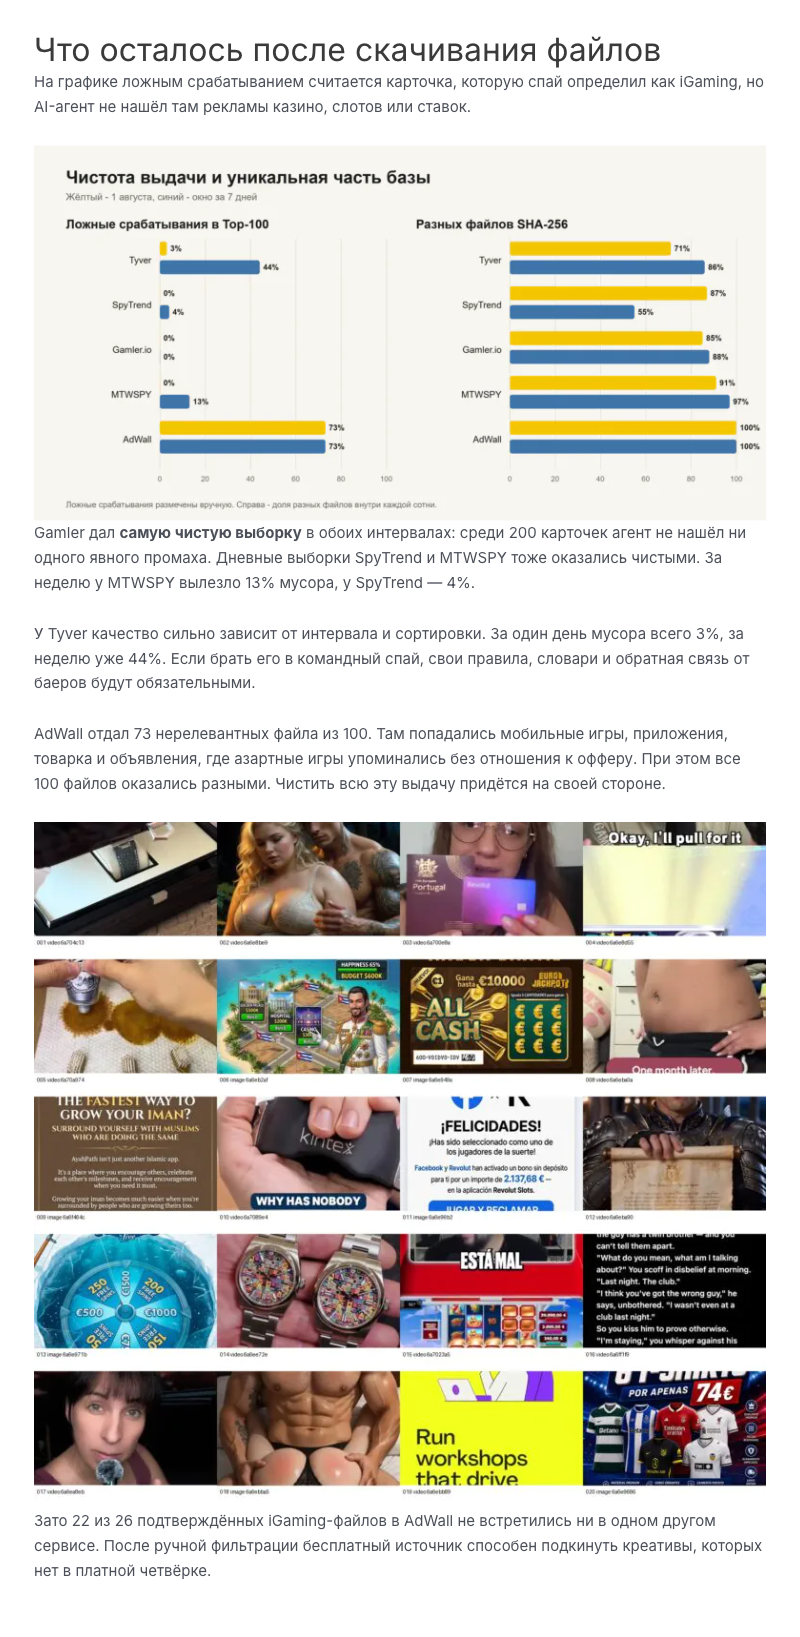
Kết quả đo ghi nhận gì. Tác giả đo tỷ lệ mẫu thực sự liên quan đến iGaming: AI agent xếp từng tệp duy nhất vào nhóm đúng chủ đề, không liên quan hoặc chưa rõ, rồi xem hết các video còn nghi vấn. Trong cả tuần, chúng tôi có 4% mẫu không liên quan; mẫu theo ngày không có mẫu sai chủ đề.
Điều rút ra từ kết quả này. Càng ít quảng cáo không liên quan, bạn càng có nhiều thời gian xem xét creative. Hãy áp tỷ lệ mẫu đúng chủ đề trong bài thử vào tổng lượng quảng cáo để ước tính mỗi dịch vụ có bao nhiêu quảng cáo đúng chủ đề.
Với MTWSPY, agent dừng thu thập ở mức hơn 500 mẫu để tiết kiệm hạn mức — con số 435 được tính từ mẫu đó, không phải toàn bộ cơ sở dữ liệu.
Cách tính. Với AdWall, chúng tôi áp tỷ lệ đúng chủ đề 27% cho 16.369 mẫu; với Tyver, áp 56% cho 11.497 mẫu. Cả hai lượng dữ liệu đều lấy từ biểu đồ trong nghiên cứu Yellow Web — chúng tôi không tính lại. Gamler không có mẫu sai chủ đề, nhưng lượng dữ liệu nhỏ hơn nhiều. Tại thời điểm thử nghiệm, cơ sở dữ liệu Spytrend có 24.985 quảng cáo cho tuần đó; 96% đúng chủ đề tương đương 23.986 — con số có thể so sánh với các dịch vụ còn lại. Biểu đồ trên dùng lượng dữ liệu tại lần đo lại ngày 11 tháng 9 năm 2026: 29.150 quảng cáo, ước tính 27.984 quảng cáo đúng chủ đề. Đây là phép ước tính, không phải kết quả kiểm tra từng quảng cáo: tỷ lệ đúng chủ đề được đo trên 100 mẫu rồi ngoại suy cho toàn bộ dữ liệu. Chỉ kiểm tra hết mọi quảng cáo mới cho con số chính xác.
4. Kết quả trùng lặp
Trùng lặp do thiết lập thu thập: bật bộ lọc mẫu duy nhất sẽ có 100 creative khác nhau trong 100 kết quả
“Trong kết quả theo tuần, Spytrend có nhiều mẫu trùng nhất: một tệp xuất hiện trên 28 thẻ quảng cáo, khiến 100 thẻ chỉ còn 55 tệp khác nhau”.
Phép đo dùng cách sắp xếp theo lượt xem: “Tyver, Spytrend và MTWSPY cho phép sắp xếp kết quả theo lượt xem”.
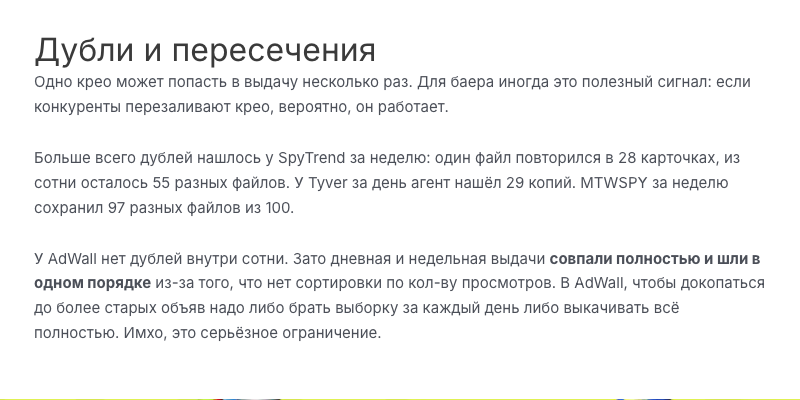
Kết quả đo ghi nhận gì. Trên các mẫu của tác giả, chúng tôi cũng đếm được 55 tệp khác nhau cho cả tuần và 87 tệp cho một ngày. Kết quả này tái lập được, không có gì phải tranh cãi.
Vì sao có kết quả đó. Agent thu thập kết quả theo lượt xem mà không bật bộ lọc mẫu duy nhất. Cách sắp xếp này đẩy quảng cáo từ những ngày đầu tuần lên trước — đến lúc đó, chúng đã được chạy lại từ các fan page khác nhau, khiến một creative chiếm 28 trong 100 thẻ.
Sắp xếp “theo lượt xem” không cho ra top quảng cáo gambling — vì không có dữ liệu lượt hiển thị để làm căn cứ
Trong tài liệu Ad Library API — giao diện lập trình công khai của Thư viện quảng cáo của Meta — trường impressions (lượt hiển thị) được ghi “Available only for POLITICAL_AND_ISSUE_ADS”: chỉ có cho quảng cáo chính trị và các vấn đề xã hội. Ngay cả với nhóm này, dữ liệu cũng chỉ là các khoảng, từ “dưới 1.000” đến “trên 1 triệu”. Bạn có thể kiểm tra trong mô tả chính thức của đối tượng quảng cáo: developers.facebook.com/docs/graph-api/reference/archived-ad.
Quảng cáo tại châu Âu có trường eu_total_reach — ước tính số người tiếp cận trên toàn châu Âu trong suốt thời gian quảng cáo chạy. Nhưng phạm vi tiếp cận tích lũy cũng không chỉ ra creative tốt nhất: quảng cáo chạy lâu đơn giản là có thêm thời gian để tiếp cận người xem.
Quan trọng hơn, Facebook tính riêng từng lần tải lên. Cùng một creative được chạy từ 5 tài khoản khác nhau sẽ được Facebook xem là 5 creative riêng, mỗi creative có số lượt hiển thị riêng. Nền tảng không nhận biết đó là cùng một hình ảnh.
Spytrend nhóm các lần tải lên dựa trên độ tương đồng của chính ảnh hoặc video. Nhờ vậy, bạn thấy được điều Facebook không thể hiện: creative đó thực sự được chạy lại bao nhiêu lần. Con số này không bị làm tròn thành một khoảng và không mất đi khi creative tiếp tục được chạy lại. Những creative được chạy lại hàng loạt thường thu hồi được chi phí, vì vậy số lần chạy lại là một tín hiệu. Chúng tôi đã hướng dẫn cách nhận ra hoạt động scale từ tín hiệu này trong bài về xu hướng creative và các lần chạy lại.
Chạy lại ngày 11 tháng 9 năm 2026. Công tắc “Chỉ mẫu duy nhất” ở hàng bộ lọc đầu tiên gộp mọi bản sao của một creative thành một dòng. Trên cùng dữ liệu, chúng tôi có 100 creative khác nhau trong 100 kết quả — bạn không cần tự lọc rồi tính lại mã băm.
Con số 88 trên biểu đồ là lần chạy của chúng tôi khi sắp xếp theo ngày: cả khoảng một ngày lẫn một tuần đều có cùng 100 quảng cáo đầu tiên nên số tệp khác nhau bằng nhau. Con số 87 ở trên thuộc phép đo khác: 100 mẫu theo ngày của tác giả, được lấy khi sắp xếp theo lượt xem.
Cách hoạt động. Hệ thống so sánh trực tiếp hình ảnh và video, không dựa vào tên tệp hay liên kết. Vì thế, creative vẫn được nhận ra khi chạy lại, nén lại, cắt xén hoặc thay phụ đề. Bên cạnh mỗi creative, bạn thấy nó xuất hiện trong bao nhiêu quảng cáo — mẫu nào được chạy lại nhiều nhất sẽ rõ ngay.
Một điểm nữa. Bản thân các kết quả lặp không phải dữ liệu rác. Một creative xuất hiện trong 28 thẻ cho thấy tổ hợp đó đang được scale: đây là lý do để xem kỹ cách đối thủ triển khai.
5. Mức độ trùng nhau giữa các cơ sở dữ liệu
Bài thử so sánh 100 kết quả đầu tiên, không phải toàn bộ cơ sở dữ liệu
“Tôi đếm các kết quả trùng giữa các dịch vụ bằng SHA-256, rồi kiểm tra thêm bằng PDQ”.
“Trong cả tuần, 92–100% tệp của mỗi nguồn không xuất hiện trong 100 kết quả đầu tiên của các nguồn khác. Ngay cả Gamler và MTWSPY, vốn có phạm vi tương tự, cũng chỉ trùng 7 tệp”.
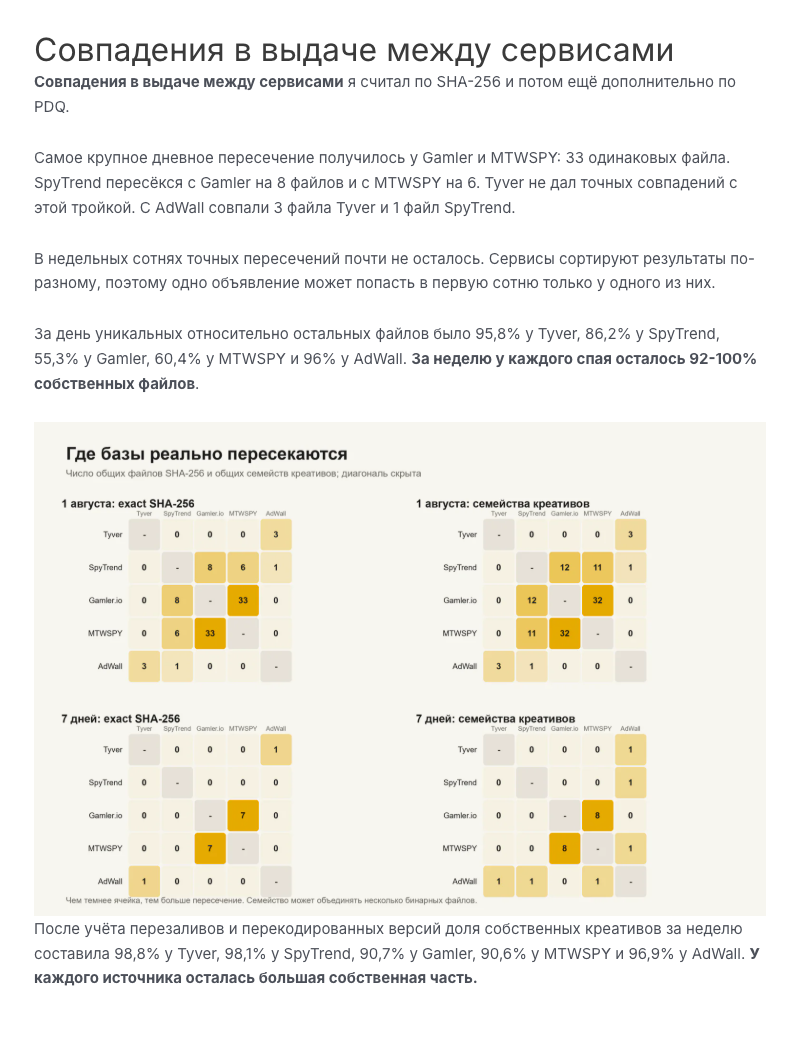
Kết quả đo ghi nhận gì. Với mỗi dịch vụ, 92–100% tệp không xuất hiện trong 100 kết quả đầu tiên của các dịch vụ khác. Với Spytrend, sau khi tính đến các lần chạy lại, tỷ lệ này là 98,1%.
Cả 5 dịch vụ đều cho tỷ lệ trong cùng một khoảng — nên con số này không phản ánh mức độ trùng nhau giữa các cơ sở dữ liệu. Tỷ lệ được tính trên 100 thẻ, bất kể đằng sau 100 thẻ đó có bao nhiêu quảng cáo. Trong tuần thử nghiệm, Gamler có 849 quảng cáo đúng chủ đề, còn chúng tôi có 23.986, nhưng tỷ lệ tệp không trùng của cả hai đều nằm trong khoảng 92–100%. Một chỉ số không phân biệt được cơ sở dữ liệu 849 quảng cáo với cơ sở dữ liệu 23.986 quảng cáo đang phản ánh cách sắp xếp kết quả, không phải mức độ trùng nhau của dữ liệu.
100 thẻ chỉ là một phần rất nhỏ của tổng lượng dữ liệu. Tương đương 3,2% kết quả ngày 1 tháng 8 và 0,4% kết quả theo tuần. Hai cơ sở dữ liệu có thể trùng một nửa nhưng vẫn trả về 100 kết quả đầu tiên khác nhau, chỉ vì cách sắp xếp mặc định khác nhau.
Tác giả đã làm đúng khi bổ sung phép so sánh theo nội dung hình ảnh và video. SHA-256 riêng lẻ chưa đủ, nên tác giả bổ sung PDQ và vPDQ để so ảnh và video thay vì chỉ so từng byte. Công cụ này phù hợp, nhưng nó chỉ làm phép so sánh các nhóm 100 mẫu chính xác hơn, không biến phép thử đó thành phép so sánh toàn bộ cơ sở dữ liệu.
Thêm một chi tiết kỹ thuật về tệp. SHA-256 là mã kiểm tra: chỉ khớp khi tải về đúng cùng phiên bản tệp. API có thể trả về video gốc, bản nén hoặc khung hình xem trước của cùng một video. Phép so sánh theo nội dung hình ảnh phát hiện được một số trường hợp như vậy, nhưng vẫn không thể trực tiếp đối chiếu một khung hình với cả video.
Cách đo mức độ trùng nhau giữa các cơ sở dữ liệu. Hãy đối chiếu theo Library ID — mã Facebook gán cho từng quảng cáo — trên toàn bộ kết quả của một giai đoạn, thay vì chỉ 100 kết quả đầu tiên. Khi đó, cùng một quảng cáo được nhận diện là một quảng cáo ở cả hai dịch vụ và tỷ lệ trùng được tính trên toàn bộ dữ liệu.
6. MCP trong thực tế
Spytrend xuất hiện hai lần trong bảng thử nghiệm — nhưng đều là cùng một máy chủ: nhật ký ghi nhận 43/43 lệnh gọi thành công
“Spytrend MCP qua một agent riêng — 0/8, 8 lỗi, thời gian phản hồi trung bình 178,96 giây”.
“Spytrend SDK truy cập API trực tiếp — 15/15, 0 lỗi, 1,69 giây”.
“Vấn đề xuất hiện khi làm việc với Spytrend qua MCP. Ban đầu là bước xác thực; sau đó mỗi lệnh gọi lại khởi tạo một phiên agent riêng và mất khoảng ba phút”.
“Nhân tiện, đội ngũ đã cập nhật MCP gần đây, nên có lẽ vấn đề đã được giải quyết”.
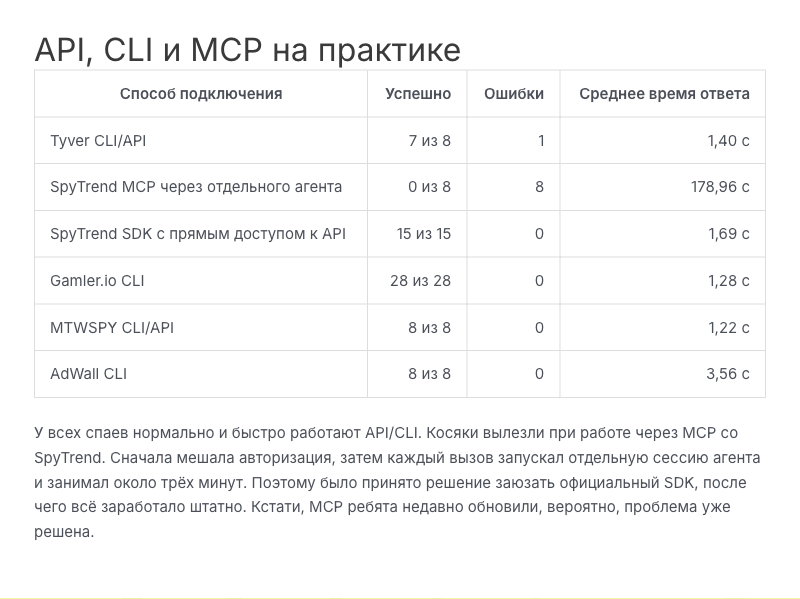
Hãy bắt đầu từ câu trích cuối. Chính tác giả cho rằng vấn đề có lẽ đã được giải quyết — và nhận định đó đúng. Dưới đây là nhật ký máy chủ kèm ngày tháng để xác nhận.
Kết quả đo ghi nhận gì. Bảng có hai dòng về Spytrend: “0/8” qua MCP và “15/15” qua “SDK truy cập API trực tiếp”.
Vì sao có kết quả đó. Cả hai dòng đều trỏ đến cùng một máy chủ của chúng tôi. Spytrend không có SDK riêng và trước đây cũng chưa từng có. Công cụ trong bài thử kết nối tới mcp.spytrend.com/mcp qua OAuth2 client credentials — cơ chế xác thực tiêu chuẩn bằng cặp khóa cấp cho agent. Dòng “SDK truy cập API trực tiếp”, với kết quả 15/15 và 1,69 giây, thực ra vẫn là MCP đó, chỉ được gọi theo cách khác.
Vậy chênh lệch giữa “0/8” và “15/15” không nằm ở máy chủ mà ở lớp trung gian. Tác giả kết nối tới dịch vụ của chúng tôi qua công cụ dòng lệnh tự viết; công cụ này khởi tạo phiên agent mới cho mỗi yêu cầu. Vì thế, 178,96 giây không phải thời gian phản hồi của máy chủ chúng tôi mà là thời gian của cả chu trình: khởi tạo agent, xác thực, kết nối, rồi mới thực hiện tìm kiếm.
Lần chạy lại. Nhật ký ngày 3 tháng 8 ghi nhận: 43 lệnh gọi, cả 43 đều thành công, trung bình 1,608 giây, trung vị 0,163 giây, không lỗi. Hoàn toàn không có phản hồi nào kéo dài gần ba phút. Trong lần chạy lại ngày 11 tháng 9 năm 2026, chúng tôi thực hiện 10 lệnh gọi liên tiếp trong cùng một phiên: trung vị dao động 0,77–0,93 giây, không lỗi.
Nhưng tổn thất lớn hơn nằm ở chỗ khác. MCP không chỉ là tập hợp các điểm truy cập. Máy chủ còn cho agent biết cách làm việc với dịch vụ: cung cấp sơ đồ bộ lọc, danh sách cách sắp xếp hiện có và hướng dẫn cho từng công cụ — nên tìm gì, thu hẹp kết quả ra sao, có những công tắc nào. Lớp trung gian tự viết làm mất phần này: dữ liệu tới được agent, còn hướng dẫn thì không.
Vì vậy, agent dùng bộ lọc không phù hợp và không tìm thấy “Chỉ mẫu duy nhất” — bộ lọc đã có trong mô tả công cụ tìm kiếm của chúng tôi từ tháng 6 và có thể gộp các bản lặp chỉ với một tham số. Đây là nguồn gốc của 55 tệp trong 100 mẫu ở mục 4 và một phần các ô trống trong bảng bộ lọc ở mục 1. Không phải máy chủ cung cấp quá ít; lớp trung gian đã không hỏi lấy thông tin đó.
Những gì thay đổi sau bài thử. Yêu cầu sắp xếp theo lượt hiển thị giờ không còn được chấp nhận âm thầm: máy chủ từ chối, liệt kê các lựa chọn dùng được và đưa ví dụ lệnh gọi —
date (theo ngày), most_popular (xếp hạng phổ biến),
folder_added (theo lượt lưu vào thư mục) và most_reused_creative
(theo số lần creative được chạy lại). Agent kết nối trực tiếp sẽ không lặp lại lựa chọn sai này.
7. Mức sử dụng hạn mức
Toàn bộ bài thử dùng 201 token — bằng khoảng nửa phần trăm hạn mức tháng
“Spytrend chủ yếu trừ hạn mức khi tải 200 tệp”. Bài thử dùng 201 đơn vị trên gói Pro giá 79 USD/tháng.
“Các dịch vụ tính lượt xem, lượt tải tệp và yêu cầu API khác nhau, nên rất tiếc không thể so sánh công bằng chi phí cho mỗi 1.000 mẫu quảng cáo”.
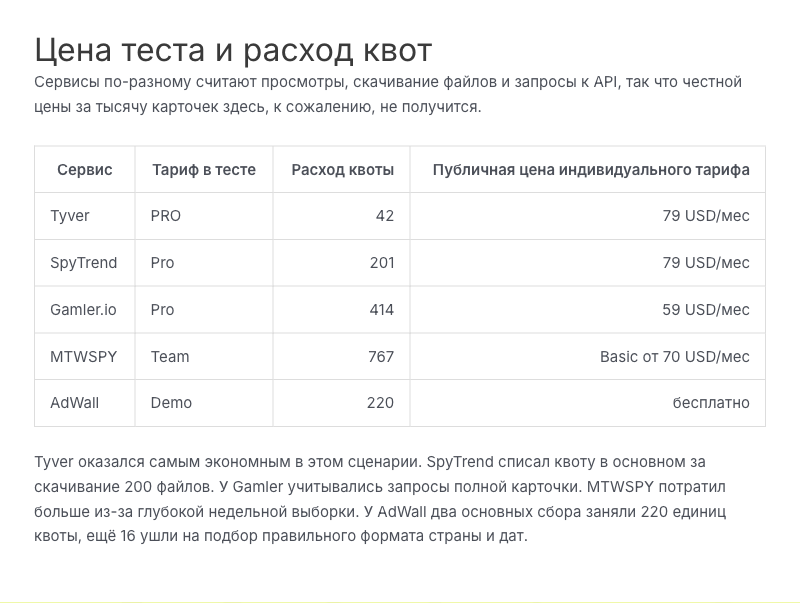
Kết quả đo ghi nhận gì. Toàn bộ bài thử dùng 201 token của Spytrend và 42 đơn vị của Tyver. Token ở đây là đơn vị hạn mức nội bộ của Spytrend, không liên quan đến token của mô hình ngôn ngữ.
Vì sao không thể so sánh trực tiếp hai con số. Mỗi dịch vụ có bảng giá và hạn mức tháng riêng, nên cùng một số đơn vị có thể chiếm tỷ lệ khác nhau trong gói đăng ký. Chỉ có một chỉ số có thể đối chiếu ở đây: phần trăm hạn mức tháng đã dùng.
Tính theo tỷ lệ phần trăm. Gói Pro có hạn mức 40.000 token mỗi tháng. Bài thử dùng 201 token, tức khoảng nửa phần trăm. Hạn mức này đủ để chạy phép thử tương tự khoảng 200 lần trong một tháng.
Vì sao phát sinh mức sử dụng đó. Thời điểm ấy, xem các trang dữ liệu mô tả không tốn hạn mức; chỉ tải tệp ảnh và video mới bị trừ hạn mức, và agent đã tải 200 tệp.
Những gì đã thay đổi. Cách tính hạn mức hiện khác và đơn giản hơn: bạn chỉ bị trừ theo dữ liệu thực sự nhận được.
| Hạng mục | Token |
|---|---|
| Một dòng trong kết quả tìm kiếm | 1 |
| Tệp ảnh hoặc video của một quảng cáo | 1 |
| Ảnh hoặc video của một creative duy nhất (một phiên bản thay vì từng lần chạy lại) | 10 |
| Một dòng từ kho dữ liệu TikTok (cơ sở dữ liệu quảng cáo TikTok riêng) | 100 |
| Hạn mức tháng của gói Pro | 40.000 |
Nếu trang kết quả có ít dữ liệu hơn yêu cầu, token chưa dùng sẽ tự động được trả lại: yêu cầu 20 dòng nhưng chỉ tìm được 12 thì chỉ tính 12. Nếu chạy lại cùng bài thử theo cách tính hiện tại, mức sử dụng vào khoảng 865 token, nhỉnh hơn 2% hạn mức tháng. Agent có thể kiểm tra số dư miễn phí.
8. Kết luận về lượng quảng cáo
Trong tuần thử nghiệm, Spytrend có khoảng 23.986 quảng cáo đúng chủ đề — gần gấp 4 lần dịch vụ xếp sau
“Spytrend đáng chú ý nhờ tính năng tìm quảng cáo trùng lặp tích hợp (…) và có cả TikTok cho người chạy quảng cáo trên nhiều nguồn. Kết quả theo ngày không có mẫu sai chủ đề, còn cả tuần cũng rất ít”.
“Bài thử này KHÔNG có dịch vụ thắng tuyệt đối, và điều đó hoàn toàn bình thường”.
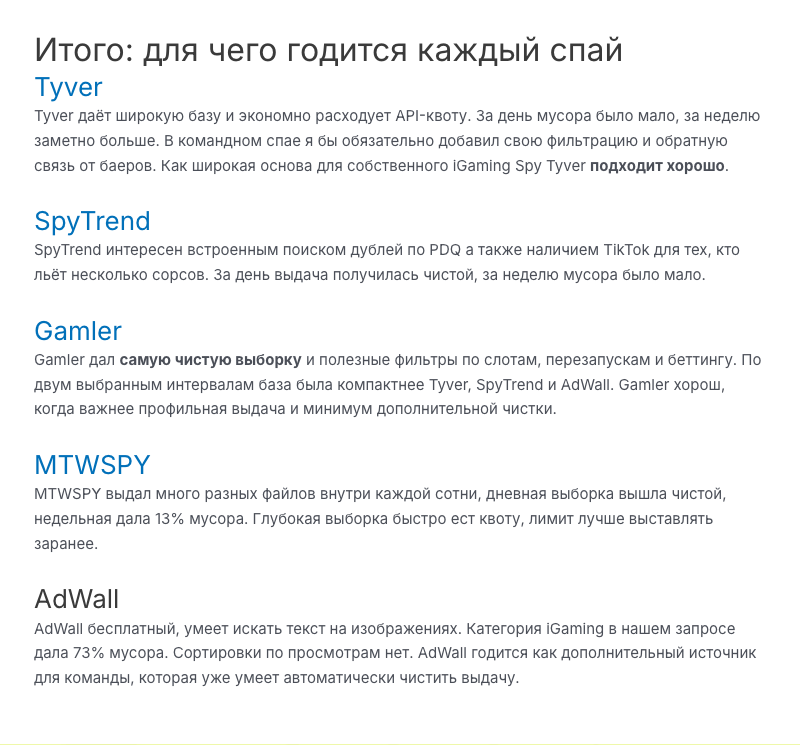
Phương pháp trong bài thử phản ánh thiết lập thu thập hơn là mức độ bao phủ của các cơ sở dữ liệu: kết quả được sắp xếp theo một chỉ số không có cho quảng cáo thương mại, bộ lọc mẫu duy nhất không được bật, còn mức độ trùng nhau giữa các dịch vụ được so bằng mã băm của những phiên bản tệp khác nhau. Bỏ ba yếu tố đó và tính lại, bức tranh đảo chiều: về số quảng cáo đúng chủ đề ước tính, Spytrend vượt từng dịch vụ còn lại nhiều lần. Cộng thêm khoảng 280 triệu quảng cáo mới mỗi tháng, 342 danh mục con, tính năng gộp mẫu trùng chỉ bằng một nút, mạng lưới webmaster, TikTok và kết nối AI agent chính thức. Trong phép so sánh 5 dịch vụ này, Spytrend đứng đầu về lượng quảng cáo đúng chủ đề ước tính cho tuần thử nghiệm.
Trước hết, để số liệu có thể so sánh. Lượng dữ liệu của 4 dịch vụ kia được lấy tại thời điểm thử nghiệm, tháng 8/2026. Để công bằng, chúng tôi dùng lượng dữ liệu Spytrend tại cùng thời điểm: 24.985 quảng cáo cho tuần từ 26 tháng 7 đến 1 tháng 8; lấy 96% đúng chủ đề cho ra ước tính 23.986. Chúng tôi cũng nêu riêng con số thứ hai: đến lần đo lại ngày 11 tháng 9 năm 2026, dữ liệu của chính tuần đó đã được bổ sung lên 29.150 quảng cáo, tức ước tính 27.984 quảng cáo đúng chủ đề. Không thể dùng con số sau để so với lượng dữ liệu tháng 8 của đối thủ — chúng tôi không tính lại dữ liệu tháng 9 của họ.
| Điều media buyer cần biết | Spytrend | 4 dịch vụ còn lại |
|---|---|---|
| Lượng dữ liệu và mức độ đúng chủ đề | ||
| Ước tính quảng cáo đúng chủ đề trong tuần | 23.986 tại thời điểm thử nghiệm 27.984 vào 11/09/2026 | Tyver 6.438 · AdWall 4.420 · Gamler 849 · MTWSPY 435 (bài thử dừng thu thập ở mức hơn 500) |
| Kết quả sai chủ đề trong tuần | 4% | Tyver 44% · AdWall 73% · MTWSPY 13% · Gamler 0% |
| Quảng cáo mới được bổ sung | khoảng 280 triệu/tháng (riêng Facebook hơn 170 triệu) | Tyver — 113 triệu trong 30 ngày (tháng 5/2026) · các dịch vụ khác không công bố |
| Phân loại | 33 danh mục, 342 danh mục con | Tyver có một vài nhóm ngành lớn |
| Khả năng tìm kiếm | ||
| Gộp quảng cáo trùng bằng một nút | có | không được ghi nhận trong bài so sánh |
| Xếp hạng theo số lần creative được chạy lại | có | Gamler có bộ đếm số lần chạy lại |
| Tìm creative theo độ tương đồng hình ảnh | có | không được ghi nhận trong bài thử; website của họ liệt kê quảng cáo “tương tự” theo trang, domain, IP hoặc nhà quảng cáo |
| Tìm theo Facebook pixel | có | không được ghi nhận trong bài thử; website của họ không nêu bộ lọc riêng (Tyver và MTWSPY tìm theo một phần liên kết) |
| Mạng lưới webmaster: domain, pixel, fan page, IP | có | không được nêu trên website của họ |
| Xác định thương hiệu phía sau lớp cloaking (mới từ tháng 9) | có, tính phí | AdWall nhận diện dấu hiệu cloaking; MTWSPY tuyên bố có thể vượt cloaking |
| Nguồn thứ hai — TikTok | có | không |
| Kết nối và giá | ||
| Kết nối AI agent (MCP) | có, OAuth 2.1 | Tyver, AdWall và MTWSPY có REST API; Gamler không có API công khai; không dịch vụ nào công bố máy chủ MCP |
| Giá | 79 USD | 59 · 70 · 79 USD, AdWall — miễn phí 30 ngày, sau đó dùng gói trả phí |
Bảng so sánh dùng số liệu của tác giả (bài thử, tháng 8/2026) và tài liệu công khai của các dịch vụ tính đến tháng 9/2026 — Tyver, AdWall, Gamler, MTWSPY. Lượng quảng cáo đúng chủ đề ước tính = tỷ lệ đúng chủ đề trong mẫu của tác giả × lượng dữ liệu của cùng giai đoạn.
Chủ động không đưa vào
Những dữ liệu chúng tôi chủ động không đưa vào bộ lọc
Không phải mọi trường dữ liệu Facebook trả về đều nên được trình bày như số liệu thực đo.
- Giới tính và độ tuổi của người xem. Facebook trả về các chỉ số này dưới dạng ước tính, không phải số đo: đó là phép quy gán dựa trên giả định về người đã thấy quảng cáo. Chính Meta cũng xếp các chỉ số này vào nhóm chỉ số ước tính và lấy mẫu. Lọc theo một trường như vậy dễ tạo cảm giác chắc chắn không có cơ sở, nên Spytrend không đưa giới tính và độ tuổi vào bộ lọc. Không phải vì không lấy được dữ liệu, mà vì chúng tôi không muốn trình bày ước tính như số liệu thực đo.
Những gì chúng tôi đã thay đổi
Những gì trở nên thuận tiện hơn sau bài thử
Bài thử giúp chúng tôi nhận ra agent thiếu hướng dẫn ở đâu. Những thay đổi kể từ tháng 8:
- Agent được hướng dẫn cách sắp xếp. Trước đây, yêu cầu sắp xếp theo lượt hiển thị vẫn được xử lý dù không có dữ liệu phù hợp. Giờ công cụ tìm kiếm giải thích lý do và đề xuất:
date,most_popular,folder_added(theo lượt lưu vào thư mục),most_reused_creative. Bạn có thể chọn quảng cáo mới, bảng xếp hạng phổ biến của chúng tôi hoặc creative được chạy lại nhiều nhất. - Có thể phân tích toàn bộ mẫu quảng cáo. Chúng tôi bổ sung tính năng phân tích theo nhà quảng cáo, quốc gia, danh mục và domain. Khoảng phạm vi tiếp cận cũng được hiển thị kèm giải thích ý nghĩa.
- Chúng tôi kiểm tra cách các bộ lọc chọn quảng cáo. Chúng tôi rà soát cả 45 tham số tìm kiếm và ghi nhận những trường hợp kết quả không đáp ứng điều kiện đã đặt.
- Đã bổ sung khả năng xác định thương hiệu phía sau lớp cloaking — 1 USD mỗi lần chạy, với mọi gói (chi tiết tại mục 1).
Còn bộ lọc “Chỉ mẫu duy nhất”, nút “Đăng lại nhiều nhất”, tìm creative theo độ tương đồng hình ảnh, theo pixel và theo một phần liên kết theo dõi, mạng lưới webmaster, TikTok và kết nối AI agent — tất cả đều đã có trên Spytrend khi bài thử diễn ra.
Kết nối qua MCP chính thức để tránh phần lớn những vướng mắc này
Bài thử cho thấy điều cốt lõi: kết quả tìm kiếm bằng AI phụ thuộc vào cách agent kết nối với dữ liệu, chứ không phải bản thân mô hình. Tự đặt một lớp trung gian lên API của dịch vụ khác sẽ tạo thêm một tầng khiến hướng dẫn từ máy chủ, danh sách cách sắp xếp hiện có và thông báo lỗi dễ hiểu bị thất lạc.
Spytrend hỗ trợ kết nối MCP chính thức: Claude, ChatGPT, Cursor, Codex và VS Code làm việc trực tiếp với cơ sở dữ liệu qua OAuth. Agent thấy sơ đồ bộ lọc hiện tại, nhận hướng dẫn thay vì gặp lỗi không rõ nguyên nhân và duy trì một phiên thay vì kết nối lại cho mỗi yêu cầu. Tài liệu ở spytrend.com/mcp; cách trợ lý Spytrend MCP hoạt động được trình bày trong hướng dẫn riêng.
Câu hỏi thường gặp
Spytrend khác Tyver thế nào khi tìm creative iGaming?
Theo phép đo của tác giả, 96% kết quả theo tuần của Spytrend đúng chủ đề iGaming, còn Tyver có 44% kết quả không liên quan trong cùng tuần. Cách phân loại cũng khác: Tyver có một vài nhóm ngành lớn (tính đến tháng 9/2026), trong khi Spytrend có 33 danh mục và 342 danh mục con, trong đó 8 danh mục phân loại riêng gambling và betting. Spytrend còn cho tìm theo chính hình ảnh của creative, theo pixel và mạng lưới webmaster.
Vì sao Spytrend hiển thị nhiều kết quả trùng hơn MTWSPY?
Kết quả được sắp xếp theo lượt xem và không bật bộ lọc mẫu duy nhất. Trong 100 thẻ như vậy, một creative chiếm 28 thẻ, chỉ còn 55 tệp khác nhau. Chúng tôi chạy lại trên các mẫu của tác giả và thu được đúng kết quả đó. Bật “Chỉ mẫu duy nhất” sẽ cho 100 creative khác nhau trong 100 kết quả.
Vì sao máy chủ MCP của Spytrend được ghi nhận 0/8 lệnh gọi thành công trong bài thử?
Tác giả kết nối qua lớp trung gian tự viết, và lớp này khởi tạo phiên agent mới cho mỗi yêu cầu — dẫn đến thời gian trung bình 178,96 giây cho cả chu trình. Nhật ký máy chủ cho phiên của tác giả ngày 3 tháng 8 ghi nhận: 43 lệnh gọi, cả 43 thành công, thời gian phản hồi trung bình 1,608 giây, trung vị 0,163 giây, không lỗi.
Spytrend trả về bao nhiêu quảng cáo iGaming tại Tây Ban Nha trong một ngày?
Agent lấy ra 996 quảng cáo cho ngày 1 tháng 8; quá trình thu thập dừng ở 100 thẻ mỗi khoảng thời gian. Cơ sở dữ liệu khi đó có 3.112 quảng cáo cho cùng ngày và truy vấn. Dữ liệu lịch sử của ngày đó tiếp tục được bổ sung trong tháng sau: phép đo ngày 11 tháng 9 năm 2026 ghi nhận 4.072 quảng cáo, và 29.150 quảng cáo cho tuần từ 26 tháng 7 đến 1 tháng 8.
Có thể dùng 100 kết quả đầu để đo mức độ trùng nhau giữa cơ sở dữ liệu của hai công cụ spy không?
Không. Bài thử so sánh 100 kết quả đầu cho một truy vấn — chỉ bằng 0,4% lượng dữ liệu theo tuần của chúng tôi. Cách sắp xếp mặc định khác nhau có thể tạo ra 100 kết quả đầu khác nhau ngay cả khi hai cơ sở dữ liệu trùng một nửa. Cần đối chiếu Library ID của quảng cáo trên toàn bộ kết quả trong một giai đoạn.
Một bài thử như vậy dùng bao nhiêu hạn mức Spytrend?
Bài thử của tác giả dùng 201 token trên hạn mức 40.000 token mỗi tháng của gói Pro — khoảng nửa phần trăm. Khi đó, duyệt các trang dữ liệu mô tả không tốn hạn mức và chỉ tải ảnh, video mới bị trừ hạn mức. Theo cách tính hiện tại, cùng bài thử sẽ dùng khoảng 865 token, nhỉnh hơn 2% hạn mức tháng.
Trong những tính năng tác giả kiểm tra, Spytrend không hỗ trợ gì?
Chúng tôi chủ động không lọc theo giới tính và độ tuổi: Facebook chỉ trả về ước tính thay vì số đo, và Meta cũng xếp các chỉ số này vào nhóm ước tính, lấy mẫu. Bộ lọc quốc gia hoạt động đúng: phần lớn kết quả là quảng cáo chạy ở nhiều quốc gia, trong đó có Tây Ban Nha. Không thể sắp xếp quảng cáo thương mại theo lượt hiển thị thực tế, vì Facebook chỉ cung cấp chỉ số này cho quảng cáo chính trị.
Cách bạn tự kiểm tra
Mã kiểm chứng sẽ chạy lại phép đo bằng tài khoản của bạn và in bảng “nhận định → số đo → kết luận”. Bạn cần Python và khóa truy cập từ tài khoản Spytrend. Không cần cài thêm thư viện:
export SPYTREND_CLIENT_ID=... # Cài đặt (Settings) → AI → Tạo quyền truy cập cho agent (Create agent access)
export SPYTREND_CLIENT_SECRET=...
python3 verify.py
Kho lưu trữ dữ liệu: https://github.com/Spytrend/yellowweb-test-verify
Bên trong có mã kiểm chứng, dữ liệu thô của cả hai lần chạy — lần thử nghiệm và lần dùng thiết lập tiêu chuẩn — cùng các lệnh chính xác, ngày chạy và phiên bản công cụ. Bạn không cần tin ngay các con số của chúng tôi; hãy tự tính lại từ dữ liệu thô.
Một lần chạy dùng khoảng 2% hạn mức tháng. Nếu tài khoản của bạn cho kết quả khác, hãy liên hệ với chúng tôi. Chúng tôi sẽ kiểm tra và công khai phân tích chênh lệch, như cách tác giả bài thử đã làm.
5 kết luận của bài thử và kết quả kiểm tra lại
| Kết luận trong nghiên cứu | Kết quả kiểm tra lại | Mục |
|---|---|---|
| MCP không hoạt động: 0/8, 179 giây | 43/43 lệnh gọi thành công, trung bình 1,6 giây. Hai dòng trong bảng đều trỏ đến cùng một máy chủ | xem mục 6 |
| 100 kết quả chỉ còn 55 tệp khác nhau | Giữ cách sắp xếp cũ, chúng tôi thu được cùng kết quả. Bật “Chỉ mẫu duy nhất”, kết quả là 100/100 | xem mục 4 |
| Các cơ sở dữ liệu gần như không trùng nhau | Thứ được so sánh là 100 kết quả đầu, không phải toàn bộ cơ sở dữ liệu: chỉ 0,4% lượng dữ liệu theo tuần. Theo phép kiểm tra bằng mã băm cảm nhận của tác giả, 98,1% tệp của chúng tôi không xuất hiện trong các nhóm 100 kết quả đầu của dịch vụ khác | xem mục 5 |
| Spytrend tìm thấy 996 quảng cáo trong một ngày | Đó là số agent lấy ra. Cơ sở dữ liệu có 3.112 quảng cáo cho ngày đó khi thử nghiệm và 4.072 vào 11/09/2026 | xem mục 2 |
| Spytrend thiếu 5 mục trong bảng bộ lọc | Hai trong 5 ô bị đánh dấu thiếu nhầm; trong bài thử (tháng 8/2026), chỉ Spytrend được ghi nhận có tìm creative theo độ tương đồng hình ảnh và theo pixel; liên kết theo dõi và mạng lưới webmaster không có trong bảng | xem mục 1 |
Bạn không cần tin chúng tôi. Hãy lấy mã kiểm chứng, dùng khóa truy cập và tổ hợp tìm kiếm của riêng bạn — một lần chạy mất 5 phút. Nếu số liệu khác nhau, chúng tôi sẽ công khai phân tích nguyên nhân.
Bạn có thể xem cơ sở dữ liệu miễn phí: gói Starter không yêu cầu thẻ, cho phép truy cập có giới hạn vào kho quảng cáo cũ hơn 90 ngày — spytrend.com.