En bref : en août 2026, le « Yellow Web » a comparé cinq services qui collectent des publicités sur les réseaux sociaux et permettent de les rechercher. L’agent IA chargé du test devait trouver des publicités iGaming — casinos en ligne, paris et loteries — diffusées en Espagne le 1er août, puis sur la semaine du 26 juillet au 1er août. Il devait récupérer les cent premières annonces de chaque période et comparer les résultats de Spytrend, Tyver, AdWall, Gamler et MTWSPY. L’auteur a publié ses outils : le test est reproductible. L’article original, « Cinq services de veille publicitaire vus par un agent IA », présente le test.
Nous sommes l’équipe Spytrend, l’un des cinq services testés. Nous avons repris les sélections d’annonces de l’auteur et relancé la même recherche. Nous publions les deux résultats : celui de l’agent pendant le test et celui obtenu avec les filtres habituels du service. Nous confirmons certains chiffres tels quels. D’autres écarts tiennent à la façon dont l’agent a interrogé la base, pas à sa taille. Pour une recherche menée par un agent IA, le résultat dépend de la façon dont l’agent est connecté aux données, et non du modèle. Le script et les deux exports permettent de vérifier nos calculs.
Guennadi, CEO de Spytrend · publié le 12 septembre 2026 · vérification fondée sur les fiches récupérées par l’auteur, les journaux du serveur et une nouvelle collecte
Les services comparés
- Spytrend (c’est nous) — plateforme de veille concurrentielle sur les publicités Facebook et TikTok : environ 1,8 milliard d’annonces, environ 280 millions de nouvelles annonces par mois, classement en 33 catégories et 342 sous-catégories, connexion officielle pour les agents IA. L’offre Pro coûte 79 USD par mois.
- Tyver — service de veille publicitaire qui classe les annonces dans quelques grandes verticales et permet de trier les résultats par vues ; il a renvoyé 11 497 annonces sur la semaine du test.
- AdWall — service de veille publicitaire avec accès gratuit pendant 30 jours ; il a renvoyé 16 369 annonces sur la semaine, mais 73 des cent premiers fichiers n’étaient pas pertinents.
- Gamler — service spécialisé doté de son propre classement et d’un compteur de relances de créas ; le seul sans annonce hors sujet dans le test, mais avec un volume de résultats nettement plus faible.
- MTWSPY — service spécialisé doté de son propre classement et d’un tri par vues ; 13 % de ses résultats hebdomadaires étaient hors sujet. Les descriptions des services ont été vérifiées sur leurs sites en septembre 2026 (Tyver, AdWall, Gamler, MTWSPY) ; les chiffres proviennent du test de « Jaune Web » (août 2026).
Les termes employés dans cet article
- L’auteur — l’auteur du « Yellow Web », qui a conçu et réalisé le test.
- L’agent — l’agent IA chargé de la recherche : il envoyait lui-même les requêtes aux cinq services et rassemblait les résultats.
- La couche intermédiaire — l’outil en ligne de commande créé par l’auteur entre l’agent et les services. Il convertissait les commandes de l’agent en requêtes. Ce qu’il ne transmettait pas restait invisible pour l’agent.
- La mesure — les chiffres obtenus par l’agent pendant le test.
- La nouvelle recherche — la même recherche, relancée sur les mêmes données avec les réglages habituels du service.
- Les réglages habituels — le fonctionnement du service lorsque les filtres laissés désactivés pendant le test sont activés.
- Les fiches de l’auteur — les sélections d’annonces récupérées par l’agent pendant le test. Nous avons travaillé sur ces mêmes fiches pour rendre les chiffres comparables.
Comment nous avons procédé
Une mesure vaut si elle est reproductible. Nous avons relancé la recherche sur les fiches de l’auteur. Quand les conditions étaient identiques, nous reprenons ses chiffres. Quand elles différaient des réglages habituels, nous montrons les deux résultats et précisons ce qui a changé. Chaque point suit le même ordre : mesure initiale → cause de l’écart → nouvelle recherche.
Ce que cette vérification ne montre pas.
- Le test comparait les cent premiers résultats, soit 3,2 % du volume quotidien et 0,4 % du volume hebdomadaire de notre base. Ces échantillons ne permettent pas de mesurer le recoupement des bases entières.
- L’auteur a mesuré la part d’annonces pertinentes sur cent fiches. Appliquer cette part au volume total donne une estimation.
L’essentiel
Trois des six écarts viennent de la façon dont l’agent interrogeait le service, et non du contenu de la base. Nous confirmons la consommation de quota. Quant aux possibilités de recherche, la grille du test montre plusieurs fonctions propres à Spytrend parmi les cinq services comparés.
- Volume des résultats. L’agent a récupéré 996 annonces Spytrend pour le 1er août et 9 526 pour la semaine. La base contenait 3 112 et 24 985 annonces pour les mêmes requêtes. → en savoir plus
- Doublons. Le test n’activait pas le filtre « Uniquement les créations uniques », qui regroupe toutes les copies d’une même créa — l’image ou la vidéo de l’annonce — sur une ligne. Sans lui, les cent fiches contenaient 55 fichiers distincts. Avec lui, les mêmes données donnent 100 créas distinctes sur 100. → en savoir plus
- Connexion de l’agent IA. Dans le test, notre serveur MCP — Model Context Protocol, la méthode officielle de connexion directe d’un agent IA au service — affichait 0 appel réussi sur 8 et 179 secondes de temps de réponse. Dans nos journaux, pour la session de l’auteur du 3 août : 43 appels réussis sur 43, aucune erreur et 1,6 seconde en moyenne. La couche intermédiaire de l’auteur ouvrait une nouvelle session d’agent à chaque requête. → en savoir plus
- Possibilités de recherche. Dans le test de « Jaune Web » (août 2026), la recherche par similarité visuelle de la créa et par pixel Facebook — le traceur installé par l’annonceur sur son site — est indiquée uniquement pour Spytrend ; la recherche par fragment d’URL de tracking et par réseau d’un webmaster — l’ensemble de ses domaines, pages et pixels — ne figure pas dans la grille du test. → en savoir plus
- Coût du test. Le test a consommé 201 tokens, l’unité interne du quota Spytrend, sans rapport avec les tokens d’un modèle de langage. Sur les 40 000 unités mensuelles de l’offre Pro, cela représente un demi-pour-cent. → en savoir plus
- Filtre géographique. Près des trois quarts des résultats pour l’Espagne étaient multigéos : les annonces ciblaient plusieurs pays, dont l’Espagne. L’agent de l’auteur les a considérées comme des erreurs alors qu’elles répondaient au filtre. Sur les résultats récents du même segment, nous n’avons trouvé aucune erreur.
Merci à l’auteur du « Yellow Web » pour son test détaillé et ses outils ouverts. Voici les huit points : la mesure, son explication et le résultat avec les réglages habituels.
Cinq conclusions du test et le résultat de notre vérification
| Conclusion du test | Vérification |
|---|---|
| MCP ne fonctionne pas : 0 appel réussi sur 8 | 43/43 ; 1,6 s |
| Sur cent fiches, il restait 55 fichiers distincts | 55 ; puis 100/100 |
| Les bases se recoupent à peine | 0,4 % comparé |
| 996 annonces pour une journée | 3 112 en base |
| Cinq absences dans la grille des filtres | Deux erreurs ; dans le test (août 2026), la similarité visuelle et le pixel ne sont indiqués que pour Spytrend → point 1 |
Huit points contestés et le résultat de notre vérification
| Point | Résultat |
|---|---|
| 1. Filtres et recherche par créa | Dans le test (août 2026), la similarité visuelle de la créa et le pixel ne sont indiqués que pour Spytrend |
| 2. Volume aux mêmes dates | 996 sorties ; 3 112 en base |
| 3. Pertinence des résultats | 96 % selon l’auteur |
| 4. Cent créas sans répétition | Doublons liés aux réglages |
| 5. Recoupement des bases | Non mesurable sur 100 |
| 6. Connexion de l’agent IA | Même serveur, deux noms |
| 7. Consommation du quota | 201 tokens ; 0,5 % |
| 8. Résultat pour le media buyer | Plus que les 4 autres réunis |
Le déroulement du test et ce que sa méthode fait bien
Comparer publiquement cinq services sur une même tâche est rare. Le travail est plus rigoureux que la plupart des comparatifs du secteur.
Le protocole était le suivant : une même recherche de publicités iGaming en Espagne dans les cinq services, sur deux périodes — le 1er août et la semaine du 26 juillet au 1er août. Pour chacune, l’agent récupérait les cent premières fiches de chaque service et téléchargeait les médias. Il regardait entièrement les annonces dont la pertinence était incertaine, puis cherchait les fichiers communs aux services avec deux types de hash. Voici ce que la méthode réussit :
- Deux hash au lieu d’un. L’auteur a cherché les correspondances avec SHA-256, une empreinte du fichier, puis avec PDQ et vPDQ, des hash perceptuels pour les images et les vidéos. Cette seconde étape repère les copies compressées ou recadrées que la comparaison des octets manquerait.
- Des comptes séparés. Les fiches, les fichiers téléchargés et les versions visuelles d’une même créa étaient comptés séparément. Le test a ainsi montré que « cent fiches » et « cent créas » ne désignent pas la même chose.
- Les vidéos douteuses étaient regardées en entier. L’agent jugeait la pertinence en visionnant le contenu, sans se fier au nom du fichier ni au texte de l’annonce. Il classait chaque fichier unique comme pertinent, hors sujet ou incertain. Sur nos cent fiches hebdomadaires, quatre fichiers étaient hors sujet : nos 4 % viennent de cet examen.
- Des outils ouverts et un cadre clair. L’auteur a publié sa couche intermédiaire et écrit qu’il n’y avait pas de vainqueur universel dans ce test. Le protocole applique une même requête, les mêmes dates et le même pays aux cinq services. Cela permet de refaire les calculs. Nous l’avons fait, et obtenons un tableau différent de sa synthèse.
Ce que nous confirmons
Ce que le test a bien mesuré
Commençons par les résultats que nous avons reproduits à l’identique. Ce ne sont pas des réserves avant nos objections : ces résultats sont reproductibles.
- Les annonces multigéos. Une annonce cible souvent plusieurs pays, dont l’Espagne. L’agent les a jugées hors du périmètre espagnol. Sur les résultats actuels du même segment, nous n’avons pas trouvé d’erreur.
- 55 fichiers distincts sur cent avec le tri par vues utilisé par l’agent. Sur les fiches de l’auteur, nous obtenons aussi 55 fichiers pour la semaine et 87 pour la journée. Le filtre d’unicité était désactivé.
- Un coût de quota supérieur. Spytrend a consommé 201 unités, contre 42 chez Tyver. À cette date, la consommation venait du téléchargement des médias ; l’agent a téléchargé 200 fichiers.
- Des résultats hors sujet. Sur la semaine, 4 % des fiches étaient non pertinentes selon le classement établi après visionnage de chaque fichier par l’agent de l’auteur.
- MCP n’a effectivement pas fonctionné via la couche intermédiaire. Huit appels, huit erreurs. Nous revenons sur les journaux du serveur au point 6.
1. Filtres et recherche
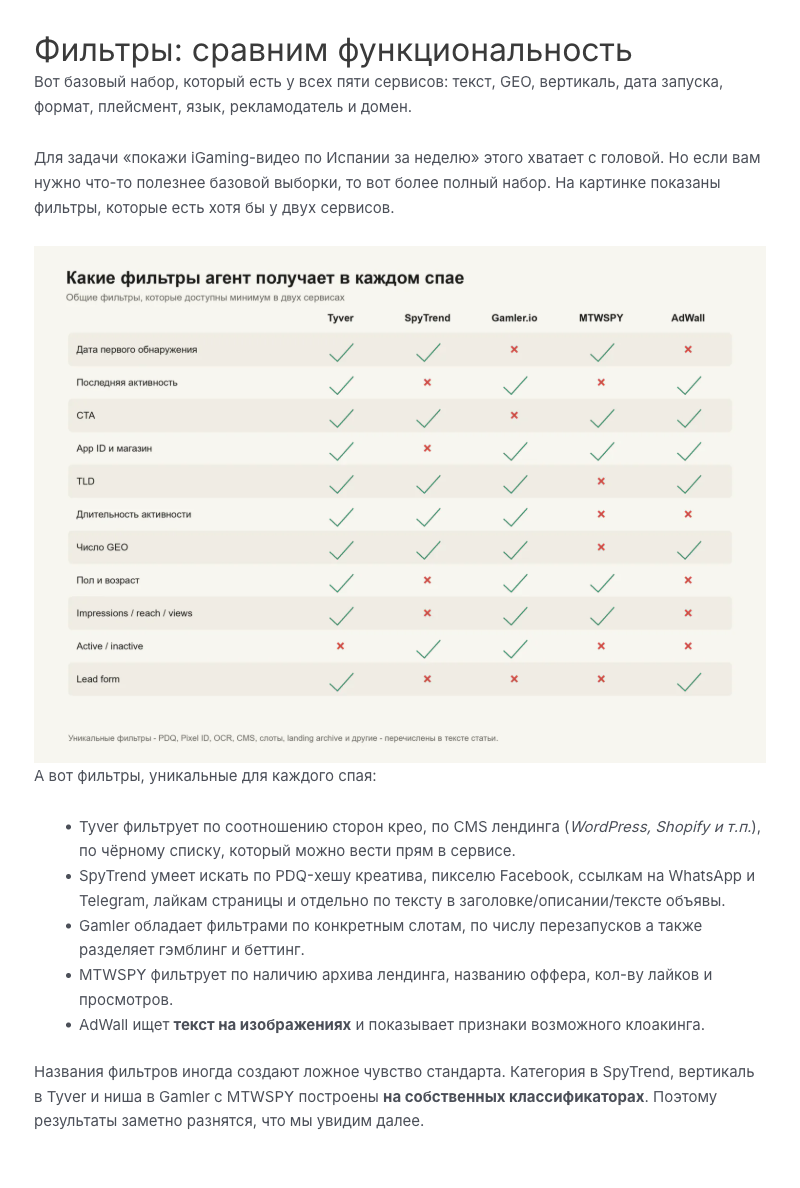
Deux cases manquaient à tort dans la grille ; les filtres distinctifs des concurrents existaient aussi chez nous pendant le test : d’une créa au réseau d’un webmaster
Extrait du test du « Yellow Web »
« Les noms des filtres donnent parfois une fausse impression d’équivalence. La catégorie de Spytrend, la verticale de Tyver et la niche de Gamler ou MTWSPY reposent sur leurs propres classements. »
La grille laisse cinq cases vides pour Spytrend. L’auteur distingue le cloaking, les relances de créas et la séparation entre gambling et betting parmi les possibilités des concurrents.
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. Dans la grille des recherches possibles, cinq cases restaient vides pour Spytrend : dernière activité, App ID et boutique, sexe et âge, impressions / portée / vues, formulaire de lead. Le cloaking, les relances de créas et la séparation du gambling et du betting figuraient comme filtres distinctifs d’autres services. Ils existaient pourtant déjà dans Spytrend sous d’autres noms : le cloaking, qui substitue une page à une autre, se repère dans l’onglet « Cloaké » et avec le filtre « Uniquement les annonces cloquées » ; les relances de la même créa depuis d’autres comptes apparaissent avec « Créas les plus réutilisées », et leur nombre figure sur la fiche ; huit sous-catégories permettent de séparer gambling et betting.
Pourquoi. Deux des cinq cases vides l’étaient à tort : le filtre de dernière activité existait pendant le test, tout comme la recherche d’applications par App ID, nom ou lien, avec un choix de boutique à côté. L’agent ne les a pas vus pour la même raison qu’il n’a pas vu « Uniquement les créations uniques » : le serveur fournit la liste des filtres, mais la couche intermédiaire ne la transmettait pas. Nous ne proposons volontairement ni sexe, ni âge, ni nombre d’impressions : Facebook présente les deux premiers comme des estimations et ne fournit pas les impressions des publicités commerciales. Nous n’avons effectivement pas de filtre pour les annonces avec formulaire de lead. Les huit sous-catégories sont Online Casino Slots, Sportsbook, Crash and Plinko, Poker, Lottery, Esports Betting, Fantasy Sports et State Restricted Operators.
Ce que l’auteur a relevé, et ce qui manque à la grille. L’étude mentionne la recherche par similarité visuelle de la créa et par pixel Facebook, visibles aussi sur le graphique ci-dessous. Deux autres possibilités n’apparaissent pas dans la grille : la recherche par fragment d’URL de tracking et l’accès au réseau d’un webmaster. À partir d’une créa, le media buyer peut retrouver les domaines, pixels et pages Facebook depuis lesquels un même acteur diffuse ses publicités.
Ce qui reste inchangé. Spytrend ne filtre ni par sexe, ni par âge, ni par plage d’impressions. Le point 4 revient sur les données d’impressions des publicités commerciales.
Nouveauté de septembre
Découvrir la vraie page derrière le cloaking coûte 1 $
Auparavant, le cloaking masquait la suite du parcours : on voyait la page blanche vers laquelle menait l’annonce, sans savoir ce que le concurrent présentait réellement. Une commande figure désormais sur la fiche de la créa, dans « Publicités ». Spytrend accède à la version cachée de la page, suit le parcours et ses redirections jusqu’au bout, installe et lance l’application si celui-ci mène à une PWA ou à un APK — application web ou fichier d’installation Android —, puis identifie la marque de l’opérateur, qu’il s’agisse d’un casino, d’un bookmaker ou d’un autre acteur.
Le compte reçoit un rapport sur toute la chaîne : captures à chaque étape, destinations et issue du parcours. La page voulue peut être téléchargée dans une seule archive. Le guide des sites et pages de destination dans Spytrend explique comment examiner ensuite les pages des concurrents. Le prix est de 1 $ par lancement, quelle que soit l’offre. En cas d’échec, le paiement est remboursé.
Résultat de la nouvelle recherche : dans le test de « Jaune Web » (août 2026), la recherche par similarité visuelle de la créa et par pixel Facebook est indiquée uniquement pour Spytrend ; la recherche par fragment d’URL de tracking et par réseau de webmaster ne figure pas dans la grille du test. Trois des cinq « absences » correspondaient à des fonctions déjà présentes sous d’autres noms pendant le test. Depuis septembre, la marque derrière le cloaking peut être identifiée pour 1 $ par lancement, quelle que soit l’offre.
2. Volume de la base
Les 996 annonces sont la sélection de l’agent, pas la taille de la base : elle en contenait 3 112 pour la même date
Extrait du test du « Yellow Web »
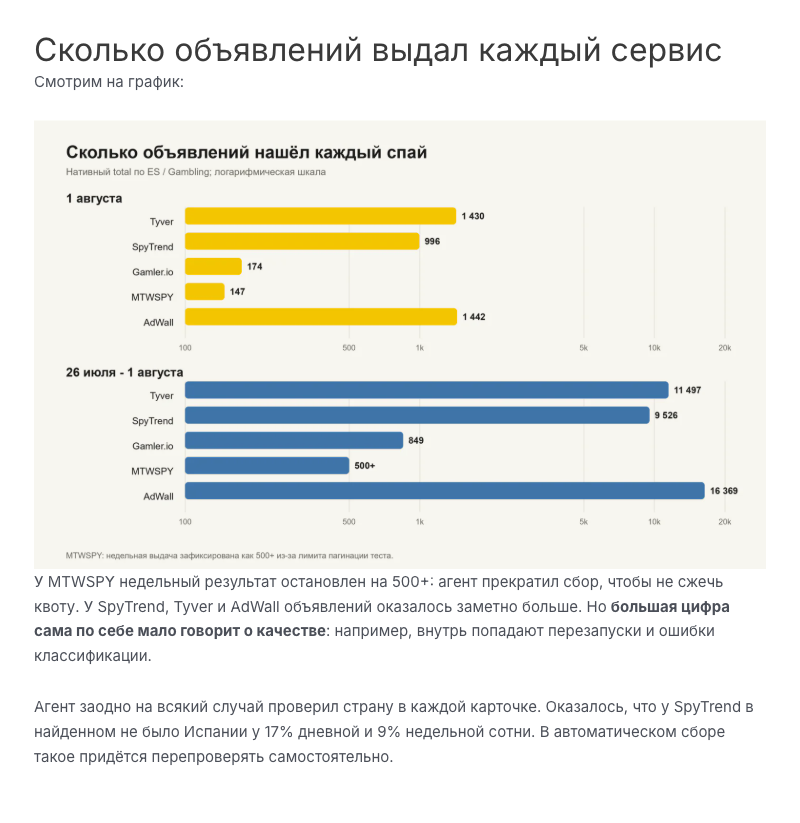
« Spytrend, Tyver et AdWall avaient nettement plus d’annonces. Mais un grand chiffre, à lui seul, renseigne peu sur la qualité. »
Sur le graphique : 996 annonces Spytrend pour le 1er août et 9 526 pour la semaine.
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. Pour le 01/08, l’agent a sorti 996 annonces de Spytrend ; pour la semaine du 26/07 au 01/08, 9 526.
Pourquoi. Au moment du test, la base en contenait 3 112 et 24 985 pour les mêmes requêtes. L’écart vient de la collecte : elle s’est arrêtée aux cent premières fiches de chaque période. Nos journaux ne montrent, pour ces requêtes, ni erreur, ni refus, ni quota épuisé.
Nouvelle recherche. Nous ajoutons régulièrement des annonces trouvées pour des dates passées : lorsqu’une nouvelle page Facebook, un domaine ou un réseau de webmaster est découvert, ses annonces rejoignent les résultats. Une semaine passée peut donc encore s’enrichir un mois plus tard. Le 11 septembre 2026, la base contenait 4 072 annonces pour le 1er août et 29 150 pour la même semaine.
En pratique. Si vous avez trouvé il y a un mois une combinaison de créa, page et domaine qu’un acteur diffusait, revenez la consulter. D’autres annonces et liens portant sur les mêmes dates peuvent avoir été ajoutés ; ils montrent comment elle a été lancée et étendue.
Résultat de la nouvelle recherche : l’agent a sorti 996 annonces pour une journée alors que la base en contenait 3 112. Sa collecte s’arrêtait à cent fiches par période.
3. Pertinence des résultats
Sur la semaine, 96 % des résultats Spytrend concernaient l’iGaming : c’est la mesure de l’auteur
Extrait du test du « Yellow Web »
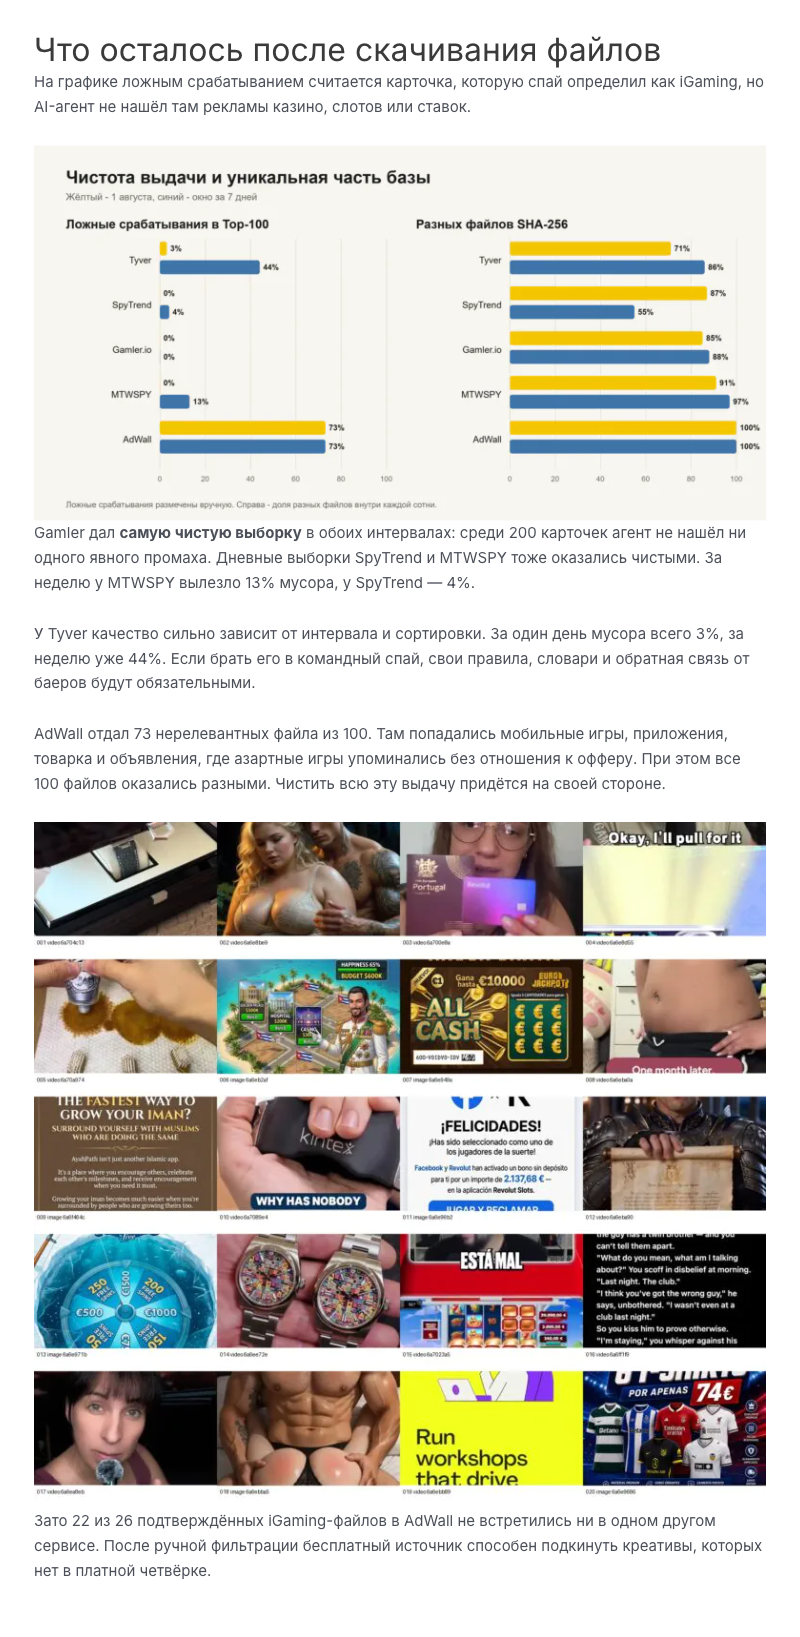
« Les sélections quotidiennes de Spytrend et MTWSPY étaient propres elles aussi. Sur la semaine, MTWSPY avait 13 % de résultats hors sujet et Spytrend 4 %. »
« Chez Tyver, la qualité dépend beaucoup de la période et du tri : 3 % de résultats hors sujet sur une journée, mais 44 % sur la semaine. » « AdWall a fourni 73 fichiers non pertinents sur 100. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. L’auteur a mesuré la part des fiches relevant vraiment de l’iGaming. Son agent IA classait chaque fichier unique comme pertinent, hors sujet ou incertain, et regardait entièrement les vidéos incertaines. Chez nous, 4 % des fichiers de la semaine étaient hors sujet ; la sélection quotidienne était propre.
Ce que cela implique. Moins de résultats hors sujet laisse davantage de temps pour analyser les créas. Appliquons à chaque volume d’annonces la part de fichiers pertinents mesurée par l’auteur.
Pour MTWSPY, l’agent a arrêté la collecte à plus de 500 fiches afin de préserver le quota. Son chiffre de 435 est calculé sur cette sélection, pas sur toute la base.
Calcul. Nous appliquons 27 % de fichiers pertinents aux 16 369 fiches d’AdWall, puis 56 % aux 11 497 de Tyver. Ces deux volumes viennent du graphique du « Yellow Web » ; nous ne les avons pas recalculés. Gamler n’avait aucun résultat hors sujet, mais son volume était inférieur d’un ordre de grandeur. Pour Spytrend, la base contenait 24 985 annonces de cette semaine à la date du test : avec 96 % de pertinence, cela donne 23 986 annonces comparables aux autres. Le graphique ci-dessus utilise le volume du 11 septembre 2026 : 29 150 annonces, soit 27 984 pertinentes selon le même calcul. C’est une estimation, pas un décompte exhaustif : la part de pertinence vient de cent fiches. Seul un examen de toutes les annonces donnerait le nombre exact.
Résultat de la nouvelle recherche : selon la mesure de l’auteur, 96 % des résultats hebdomadaires de Spytrend concernaient l’iGaming. En appliquant cette part au volume de la semaine, nous obtenons plus d’annonces pertinentes que les quatre autres services réunis.
4. Doublons et unicité
Les doublons venaient des réglages de collecte : le filtre d’unicité donne 100 créas distinctes sur 100
Extrait du test du « Yellow Web »
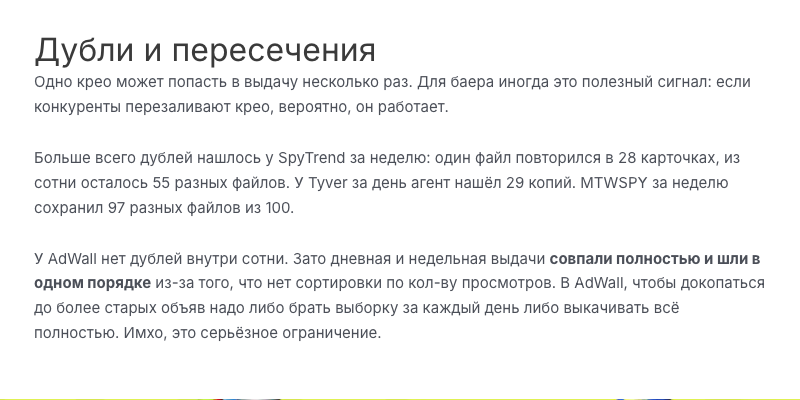
« C’est chez Spytrend qu’il y avait le plus de doublons sur la semaine : un fichier figurait dans 28 fiches et, sur cent fiches, il restait 55 fichiers distincts. »
La mesure utilisait le tri par vues : « Tyver, Spytrend et MTWSPY savent trier les résultats par vues. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. Sur les fiches de l’auteur, nous obtenons les mêmes 55 fichiers distincts pour la semaine et 87 pour la journée. Ce résultat est reproductible.
Pourquoi. L’agent triait les résultats par vues sans activer le filtre d’unicité. Ce tri rassemblait des annonces datant des premiers jours de la semaine. Certaines avaient déjà été relancées depuis plusieurs pages Facebook : une même créa occupait 28 des cent fiches.
Analyse de l’équipe Spytrend
Trier « par vues » ne donne pas le top des publicités gambling : les données manquent
Dans la documentation de l’Ad Library API, l’interface de la bibliothèque publicitaire Facebook, le champ impressions porte la mention « Available only for POLITICAL_AND_ISSUE_ADS » : il n’est disponible que pour les publicités politiques et les sujets de société. Même là, les valeurs sont des fourchettes, de « moins de 1 000 » à « plus de 1 million ». Cette restriction figure dans la description officielle des annonces archivées de Facebook.
Pour les publicités européennes, le champ eu_total_reach estime la portée en Europe : combien de personnes ont vu l’annonce sur toute sa durée de vie. Cette portée cumulée n’identifie pas non plus la meilleure créa. Une annonce diffusée longtemps a simplement eu plus de temps pour accumuler de l’audience.
Surtout, Facebook compte chaque diffusion séparément. Une même créa lancée depuis cinq comptes apparaît pour Facebook comme cinq créas distinctes, chacune avec ses propres chiffres d’impressions. Facebook ne les reconnaît pas comme une même image.
Spytrend rapproche ces diffusions par similarité de l’image ou de la vidéo. On voit ainsi combien de fois la créa a réellement été relancée. Ce nombre n’est ni ramené à une fourchette ni perdu lors d’une nouvelle relance. Les créas relancées massivement sont généralement celles qui sont rentables ; leur nombre de relances sert donc de signal. Nous expliquons comment le suivre dans notre analyse des tendances et des relances de créas.
Nouvelle recherche, le 11 septembre 2026. Le filtre « Uniquement les créations uniques », dans la première rangée de filtres, regroupe les copies d’une créa sur une ligne. Sur les mêmes fiches, nous obtenons cent créas distinctes sur cent, sans nettoyage des résultats ni nouveau calcul de hash de votre côté.
Le chiffre 88 du graphique correspond à notre recherche avec un tri par date. Il donne autant de fichiers distincts pour la journée que pour la semaine, car ce tri place les mêmes cent annonces en tête. Le chiffre 87 cité plus haut vient d’une autre mesure : les cent fiches quotidiennes de l’auteur, triées par vues.
Comment cela fonctionne. La comparaison porte sur les images et vidéos elles-mêmes, pas sur les noms de fichiers ni sur les liens. Une relance, une compression, un recadrage ou un changement de sous-titres n’empêchent donc pas de reconnaître la créa. Sa fiche indique dans combien d’annonces elle apparaît.
Un dernier point. Les répétitions ne sont pas forcément du bruit. Une créa présente sur 28 fiches signale une diffusion à plus grande échelle : cela mérite d’examiner comment l’annonceur la déploie.
Résultat de la nouvelle recherche : les doublons tenaient aux réglages de collecte, puisque « Uniquement les créations uniques » était désactivé. Une fois activé, cent fiches donnent cent créas distinctes. Le tri par impressions ne peut pas mesurer les performances des publicités commerciales : Facebook ne fournit les impressions que pour les publicités politiques.
5. Recoupement des bases
Le comparatif portait sur les cent premiers résultats, pas sur les bases entières
Extrait du test du « Yellow Web »
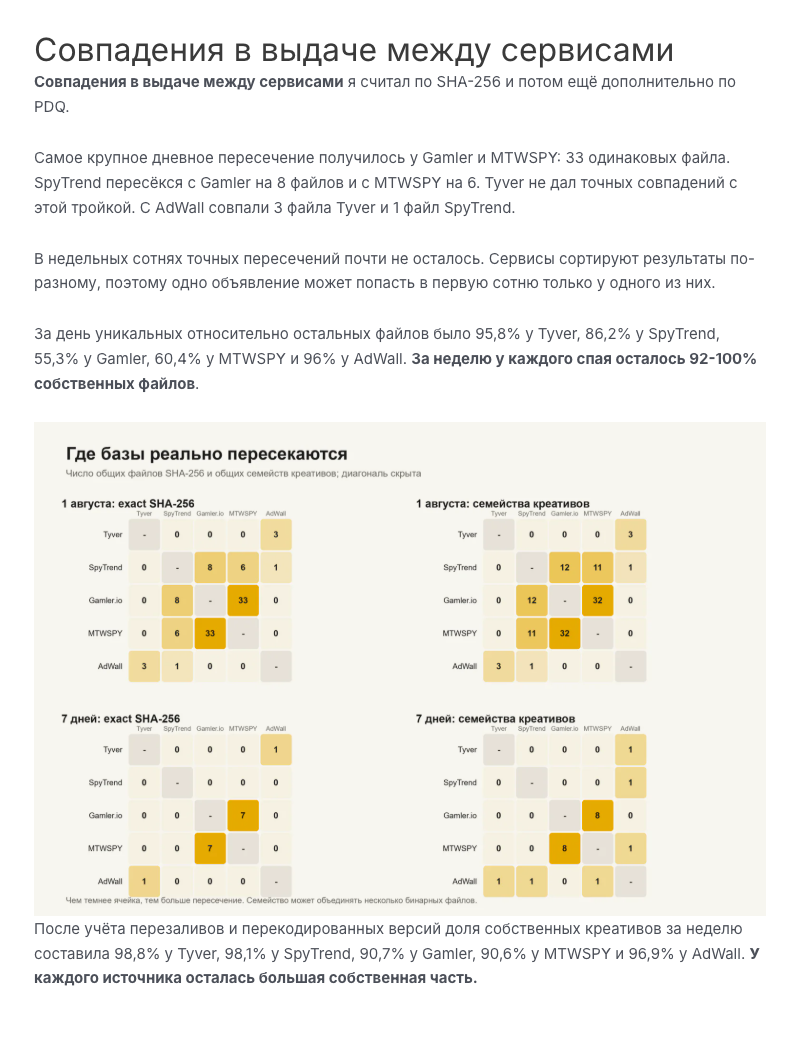
« J’ai comparé les fichiers renvoyés par les services avec SHA-256, puis aussi avec PDQ. »
« Sur la semaine, entre 92 et 100 % des fichiers de chaque source n’apparaissaient pas dans les cent premiers résultats des autres services. Même Gamler et MTWSPY, pourtant proches, n’avaient que sept fichiers en commun. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. Pour chaque service, entre 92 et 100 % des fichiers ne figuraient pas dans les cent premiers résultats des autres. Chez nous, après prise en compte des relances, cette part était de 98,1 %.
Le chiffre est proche pour les cinq services : il ne décrit donc pas leurs bases. Il est calculé sur cent fiches, quel que soit le volume derrière elles. Pour la semaine du test, Gamler comptait 849 annonces pertinentes et nous 23 986, alors que leur part de fichiers absents des autres premières centaines se situait dans la même plage de 92 à 100 %. Une mesure qui ne distingue pas ces deux volumes décrit le tri des résultats plutôt que les données disponibles.
Cent fiches représentent une fraction du volume. Elles comptent pour 3,2 % des résultats du 1er août et 0,4 % de ceux de la semaine. Deux bases qui se recoupent à moitié peuvent afficher des premières centaines différentes si leur tri par défaut diffère.
L’auteur a bien ajouté une comparaison perceptuelle. SHA-256 ne suffisait pas ; PDQ et vPDQ comparent aussi les images et vidéos, au lieu de leurs seuls octets. Ces outils affinent la comparaison des centaines de fichiers. Ils ne transforment pas cet échantillon en comparaison des bases entières.
Les versions des fichiers comptent aussi. Une empreinte SHA-256 n’est identique que si la même version du fichier est téléchargée. Une API peut fournir l’original, une copie compressée ou une image d’aperçu d’une vidéo. La comparaison perceptuelle repère une partie de ces cas, sans pouvoir comparer directement une image isolée et la vidéo entière.
Pour mesurer le recoupement des bases, il faut comparer les Library ID — les identifiants attribués par Facebook aux annonces — sur l’ensemble des résultats d’une période. Une annonce présente dans deux services est alors reconnue comme telle, et la part commune se calcule sur tout le volume.
Conclusion du point : la plage de 92 à 100 % était la même pour un service comptant 849 annonces pertinentes sur la semaine et pour un autre en comptant 23 986. Elle mesure la composition des premières centaines, pas le recoupement des bases. Celui-ci doit être calculé par Library ID sur l’ensemble des résultats de la période.
6. MCP en pratique
Spytrend apparaît deux fois dans le tableau, mais c’est le même serveur : nos journaux montrent 43 appels réussis sur 43
Extrait du test du « Yellow Web »
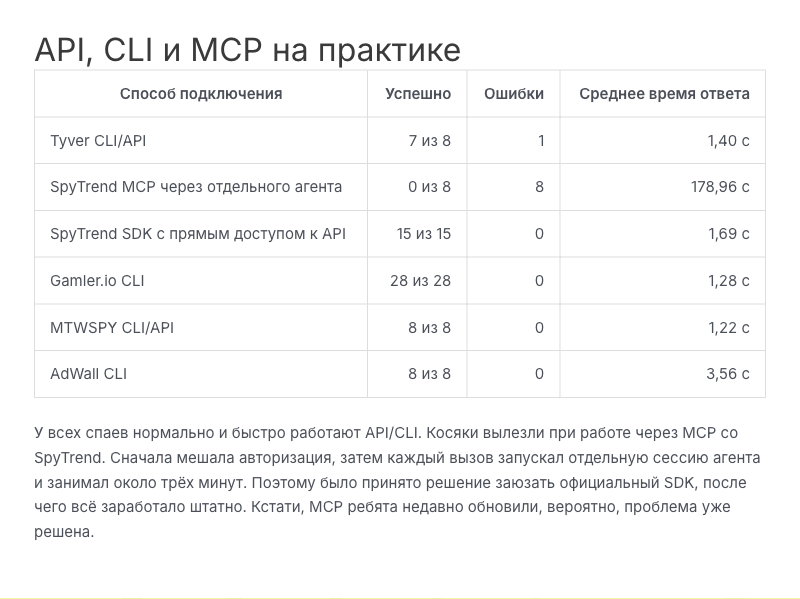
« Spytrend MCP via un agent distinct : 0 sur 8, 8 erreurs, temps de réponse moyen de 178,96 s. »
« Spytrend SDK avec accès direct à l’API : 15 sur 15, 0 erreur, 1,69 s. »
« Les problèmes sont apparus avec MCP sur Spytrend. L’authentification a d’abord bloqué, puis chaque appel lançait une session d’agent distincte et prenait environ trois minutes. »
« Au passage, l’équipe a récemment mis MCP à jour ; le problème est probablement déjà résolu. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
Commençons par cette dernière remarque. L’auteur supposait que le problème avait été résolu. Les journaux datés du serveur ci-dessous confirment que celui-ci répondait.
Ce que montrait la mesure. Le tableau comportait deux lignes Spytrend : « 0 sur 8 » via MCP et « 15 sur 15 » via un « SDK avec accès direct à l’API ».
Pourquoi. Les deux lignes correspondent au même serveur. Spytrend n’a pas de SDK distinct et n’en avait pas pendant le test. L’outil utilisait mcp.spytrend.com/mcp via OAuth2 client credentials, un accès fondé sur une paire de clés remise à l’agent. La ligne « SDK avec accès direct à l’API », à 15 appels réussis sur 15 et 1,69 s, décrit le même MCP appelé autrement. La page de connexion MCP présente cet accès.
L’écart entre « 0 sur 8 » et « 15 sur 15 » vient donc de la couche intermédiaire. L’outil en ligne de commande de l’auteur ouvrait une nouvelle session d’agent pour chaque requête. Les 178,96 s incluaient ainsi tout le cycle — lancement de l’agent, authentification, connexion, puis recherche — et pas seulement la réponse de notre serveur.
43 sur 43 appels réussis dans la session de l’auteur du 3 août
1,608 s de réponse moyenne ; médiane de 0,163 s
0 erreur
Nouvelle recherche. Nos journaux du 3 août indiquent 43 appels, tous réussis, une moyenne de 1,608 s, une médiane de 0,163 s et aucune erreur. Aucun appel n’y dure près de trois minutes. Le 11 septembre 2026, nous avons refait plusieurs séries de dix appels dans une même session : les médianes étaient de 0,77 à 0,93 s, sans erreur.
L’autre conséquence était plus importante. MCP ne fournit pas seulement des points d’accès. Le serveur décrit aussi à l’agent les filtres, la liste à jour des tris possibles et les instructions de chaque outil : quoi chercher, comment réduire les résultats et quels filtres activer. La couche intermédiaire transmettait les données, mais perdait ces indications.
L’agent a donc utilisé des filtres mal adaptés à la tâche et n’a pas trouvé « Uniquement les créations uniques ». Ce filtre figure depuis juin dans la description de notre outil de recherche et regroupe les répétitions. Cela explique les 55 fichiers sur cent du point 4 et une partie des cases vides du point 1. Le serveur disposait des fonctions ; la couche intermédiaire ne les demandait pas.
Depuis le test, une demande de tri par impressions n’est plus acceptée sans explication. Le serveur la rejette, indique les tris disponibles et donne un exemple d’appel : date pour la date, most_popular pour le classement de popularité, folder_added pour l’ajout aux dossiers et most_reused_creative pour le nombre de relances de la créa. Un agent connecté directement reçoit donc une indication pour corriger sa requête.
Résultat de la nouvelle recherche : 43 appels réussis sur 43 dans la session de l’auteur du 3 août, une moyenne de 1,608 s et aucune erreur. Les deux lignes du tableau décrivaient le même serveur ; Spytrend n’a pas de SDK distinct. La couche intermédiaire ne transmettait pas ses instructions, notamment le filtre « Uniquement les créations uniques ».
7. Consommation du quota
Le test entier a coûté 201 tokens, soit un demi-pour-cent du quota mensuel
Extrait du test du « Yellow Web »
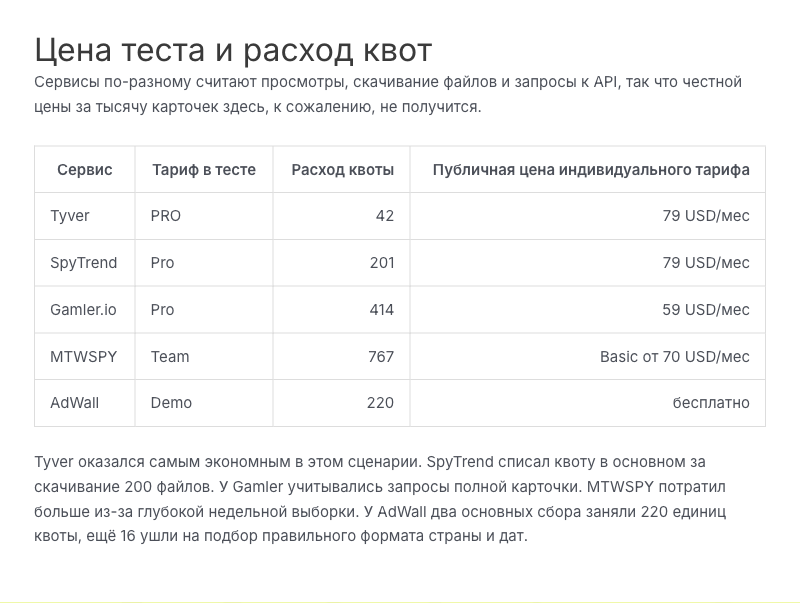
« Spytrend a surtout consommé du quota pour le téléchargement de 200 fichiers. » Le test a coûté 201 unités avec l’offre Pro à 79 USD par mois.
« Chaque service compte différemment les consultations, téléchargements et requêtes API ; on ne peut donc malheureusement pas établir un prix comparable pour mille fiches. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
Ce que montrait la mesure. Le test a consommé 201 tokens chez nous, contre 42 chez Tyver. Ici, un token est une unité interne du quota Spytrend, sans lien avec les tokens des modèles de langage.
Pourquoi ces nombres ne sont pas directement comparables. Chaque service a ses prix et sa limite mensuelle. Le même nombre d’unités peut donc représenter une part différente de l’abonnement. La mesure comparable est la part du quota mensuel consommée.
Cette part. Le quota mensuel Pro est de 40 000 tokens. Le test en a consommé 201, soit un demi-pour-cent. Un tel passage pourrait être répété environ deux cents fois dans le mois.
La cause. À l’époque, parcourir les métadonnées était gratuit ; seul le téléchargement des médias consommait du quota. L’agent a téléchargé 200 fichiers.
Ce qui a changé. La grille actuelle facture ce qui est effectivement reçu :
| Élément | Tokens |
|---|---|
| Ligne de résultats de recherche | 1 |
| Fichier média d’une annonce | 1 |
| Média d’une créa unique, plutôt que toutes ses relances | 10 |
| Ligne du corpus TikTok, base publicitaire distincte | 100 |
| Quota mensuel Pro | 40 000 |
Si une page de résultats est plus courte que prévu, les tokens non utilisés sont rendus automatiquement : pour vingt lignes demandées et douze trouvées, douze sont débitées. Aujourd’hui, le même test coûterait environ 865 tokens, soit un peu plus de deux pour cent du quota mensuel. L’agent peut consulter gratuitement le solde.
Conclusion du point : le nombre brut de tokens ne se compare pas entre services aux quotas différents. Le test a consommé 201 tokens sur les 40 000 mensuels de Pro, soit un demi-pour-cent. Avec la grille actuelle, il coûterait environ 865 tokens, autour de deux pour cent.
8. Bilan des volumes
Sur la semaine du test, Spytrend comptait 23 986 annonces pertinentes, presque quatre fois le volume du service suivant
Extrait du test du « Yellow Web »
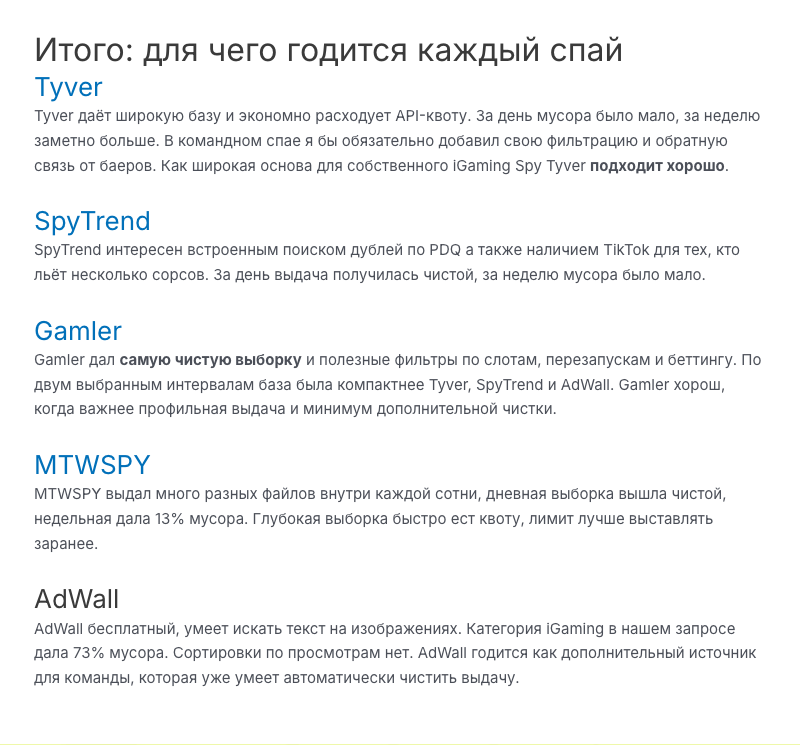
« Spytrend est intéressant pour sa détection intégrée des doublons (…), ainsi que pour TikTok si l’on achète du trafic sur plusieurs sources. Les résultats d’une journée étaient propres ; sur la semaine, il y avait peu de bruit. »
« Il n’y a PAS de vainqueur universel dans ce test, et c’est normal. »
Extrait de l’article du « Yellow Web » · ouvrir l’original
La méthode du test décrit surtout les réglages de collecte : les résultats étaient triés selon une métrique indisponible pour les publicités commerciales, le filtre d’unicité était désactivé et le recoupement des bases reposait sur les hash de différentes versions de fichiers. En corrigeant ces trois points et en recalculant, le tableau s’inverse : Spytrend compte plusieurs fois plus d’annonces pertinentes que chacun des quatre autres services. S’y ajoutent environ 280 millions de nouvelles annonces par mois, 342 sous-catégories, le regroupement des doublons par un filtre, les réseaux de webmasters, TikTok et la connexion officielle des agents IA. Dans cette comparaison des cinq services, Spytrend arrive en tête pour l’estimation des résultats pertinents sur la semaine du test.
Comparons d’abord les mêmes dates. Les volumes des quatre autres services datent du test, en août 2026. Nous utilisons donc aussi notre volume de cette date : 24 985 annonces pour la semaine du 26 juillet au 1er août. À 96 % de pertinence, cela donne 23 986. Nous indiquons séparément le chiffre du 11 septembre 2026 : la même semaine avait alors été complétée jusqu’à 29 150 annonces, soit 27 984 pertinentes selon la même estimation. Ce chiffre de septembre n’est pas comparable aux volumes d’août des concurrents, que nous n’avons pas recalculés.
| Pour le travail d’un media buyer | Spytrend | Les quatre autres |
|---|---|---|
| Volume et qualité de la base | ||
| Estimation des annonces pertinentes sur une semaine | 23 986 à la date du test 27 984 au 11 septembre 2026 | Tyver 6 438 · AdWall 4 420 · Gamler 849 · MTWSPY 435 (collecte du test arrêtée à 500+) |
| Résultats hors sujet sur une semaine | 4 % | Tyver 44 % · AdWall 73 % · MTWSPY 13 % · Gamler 0 % |
| Nouvelles annonces | Environ 280 M/mois (Facebook : plus de 170 M) | Tyver : 113 M en 30 jours (mai 2026) · non publié ailleurs |
| Classification | 33 catégories, 342 sous-catégories | Tyver : quelques grandes verticales |
| Possibilités de recherche | ||
| Regroupement des doublons en un clic | oui | non indiqué dans la comparaison |
| Classement par relances de créas | oui | Compteur chez Gamler |
| Recherche par similarité visuelle | oui | Non indiqué au test ; « similaires » par page, domaine, IP ou annonceur sur les sites |
| Recherche par pixel Facebook | oui | Non indiqué au test ; pas de filtre dédié sur les sites (Tyver et MTWSPY : recherche par fragment de lien) |
| Réseaux de webmasters : domaines, pixels, fan pages, IP | oui | Non revendiqué sur les sites |
| Révélation de la marque derrière le cloaking (nouveau en septembre) | oui, payant | Indices de cloaking chez AdWall ; MTWSPY revendique la détection du cloaking |
| Deuxième source : TikTok | oui | non |
| Connexion et prix | ||
| Connexion d’agents IA (MCP) | oui, OAuth 2.1 | REST API chez Tyver, AdWall et MTWSPY ; pas d’API publique Gamler ; aucun serveur MCP annoncé |
| Prix | 79 USD | 59 · 70 · 79 USD, AdWall : 30 jours gratuits, puis offres payantes |
La comparaison utilise les chiffres de l’auteur (test, août 2026) et les documents publics des services de septembre 2026 — Tyver, AdWall, Gamler, MTWSPY. Le nombre d’annonces pertinentes est estimé en multipliant la part pertinente de l’échantillon de l’auteur par le volume de la même période.
Résultat de la nouvelle recherche : à la date comparable du test, Spytrend comptait 23 986 annonces pertinentes sur la semaine, contre 6 438 pour le service suivant. Au 11 septembre 2026, l’estimation était de 27 984. S’y ajoutent environ 280 millions de nouvelles annonces par mois, 342 sous-catégories, le regroupement des doublons par un filtre, les réseaux de webmasters, TikTok et la connexion officielle des agents IA.
Ce qui manque volontairement
Les filtres que nous ne proposons pas volontairement
Toutes les données affichées par Facebook ne méritent pas d’être présentées comme des mesures établies.
- Le sexe et l’âge de l’audience. Facebook les fournit comme des estimations, non comme des mesures : cette attribution repose sur une hypothèse concernant les personnes qui ont vu l’annonce. Meta classe elle-même ces métriques parmi les estimations et les échantillons. Un filtre fondé sur ces champs donnerait une certitude que les données ne justifient pas. C’est pourquoi Spytrend ne filtre ni par sexe ni par âge. Ce n’est pas faute de disposer de ces données : nous ne présentons pas une estimation comme une mesure.
Ce que nous avons changé
Ce qui est plus simple depuis le test
Le test a montré où l’agent IA manquait d’indications. Depuis août :
- L’agent reçoit une indication sur le tri. Auparavant, une requête triée par impressions passait alors que les données nécessaires n’existaient pas. La recherche explique désormais le problème et propose
date,most_popular,folder_added— l’ajout aux dossiers — etmost_reused_creative. L’agent peut choisir les annonces récentes, notre classement de popularité ou les créas les plus relancées. - Une sélection entière d’annonces peut être analysée. Nous avons ajouté une analyse par annonceur, pays, catégorie et domaine. Elle affiche aussi une fourchette de portée accompagnée d’une explication.
- Nous avons vérifié la sélection opérée par les filtres. Les 45 paramètres de recherche ont été examinés pour repérer les cas où les résultats ne respectaient pas les conditions.
- La marque derrière le cloaking peut être identifiée pour 1 $ par lancement, quelle que soit l’offre, comme indiqué au point 1.
Le filtre « Uniquement les créations uniques », le tri « Créas les plus réutilisées », la recherche par similarité visuelle, pixel et fragment d’URL de tracking, les réseaux de webmasters, TikTok et la connexion des agents IA existaient déjà dans Spytrend pendant le test.
Conseil pour la recherche avec un agent
Connectez-vous par le MCP officiel pour éviter la plupart de ces difficultés
Ce test montre combien le mode de connexion aux données compte dans une recherche menée par un agent IA. Une couche créée au-dessus d’une API peut perdre les indications du serveur, la liste à jour des tris et les messages d’erreur utiles.
Spytrend propose une connexion MCP officielle : Claude, ChatGPT, Cursor, Codex et VS Code accèdent directement à la base via OAuth. L’agent voit la liste actuelle des filtres, reçoit une indication lorsqu’une requête ne convient pas et conserve une session au lieu de se reconnecter à chaque appel. Le fonctionnement de l’assistant MCP de Spytrend est détaillé dans un autre article.
FAQ
Quelle différence entre Spytrend et Tyver pour rechercher des créas iGaming ?
Selon la mesure de l’auteur, 96 % des résultats hebdomadaires de Spytrend concernaient l’iGaming, tandis que 44 % de ceux de Tyver étaient hors sujet. Tyver classe les annonces dans quelques grandes verticales (en septembre 2026) ; Spytrend utilise 33 catégories et 342 sous-catégories, dont huit distinctes pour le gambling et le betting. Spytrend permet aussi de chercher par créa, pixel et réseau de webmaster.
Pourquoi Spytrend avait-il plus de doublons que MTWSPY ?
Les résultats étaient triés par vues, sans filtre d’unicité. Dans cette sélection de cent fiches, une créa occupait 28 places et il restait 55 fichiers distincts. Nous avons reproduit ce résultat sur les fiches de l’auteur. Avec « Uniquement les créations uniques », cent fiches donnent cent créas distinctes.
Pourquoi le serveur MCP de Spytrend affichait-il 0 appel réussi sur 8 ?
La couche intermédiaire de l’auteur ouvrait une nouvelle session d’agent à chaque requête, ce qui explique la moyenne de 178,96 secondes mesurée sur ce parcours. Nos journaux de sa session du 3 août montrent 43 appels, tous réussis, une moyenne de 1,608 seconde, une médiane de 0,163 seconde et aucune erreur.
Combien d’annonces iGaming en Espagne Spytrend renvoyait-il pour une journée ?
L’agent a sorti 996 annonces pour le 1er août, sa collecte s’arrêtant à cent fiches par période. La base en contenait 3 112 pour cette date et cette requête. Après l’ajout d’annonces historiques pendant le mois suivant, la mesure du 11 septembre 2026 donnait 4 072 annonces pour la journée et 29 150 pour la semaine du 26 juillet au 1er août.
Peut-on mesurer le recoupement de deux bases de veille publicitaire avec leurs cent premiers résultats ?
Non. Le test comparait cent résultats par service pour une requête, soit 0,4 % du volume hebdomadaire de notre base. Des tris par défaut différents peuvent produire deux premières centaines distinctes même si les bases se recoupent à moitié. Il faut comparer les Library ID sur tous les résultats de la période.
Quel quota Spytrend consomme-t-il pour un test de ce type ?
Le test de l’auteur a consommé 201 tokens sur le quota mensuel Pro de 40 000, soit un demi-pour-cent. À l’époque, parcourir les métadonnées était gratuit et le quota servait au téléchargement des médias. Avec la grille actuelle, le même test coûterait environ 865 tokens, un peu plus de deux pour cent du quota mensuel.
Quelles fonctions vérifiées par l’auteur Spytrend ne propose-t-il pas ?
Nous n’avons volontairement pas de filtre par sexe ou par âge : Facebook fournit des estimations, pas des mesures, et Meta classe elle-même ces métriques parmi les estimations et les échantillons. Le filtre géographique sélectionne correctement les annonces multigéos dont l’Espagne est l’une des cibles. Il n’existe pas de tri par impressions réelles pour les publicités commerciales : Facebook ne fournit les impressions que pour la publicité politique.
Vérifier par vous-même
Comment refaire la vérification
Le script reproduit la mesure avec votre compte et affiche un tableau « affirmation → mesure → verdict ». Il vous faut Python et les clés d’accès de votre compte Spytrend. Aucune bibliothèque supplémentaire n’est nécessaire :
export SPYTREND_CLIENT_ID=... # Paramètres → IA → Créer un accès pour l’agent
export SPYTREND_CLIENT_SECRET=...
python3 verify.py
Dépôt des données : https://github.com/Spytrend/yellowweb-test-verify
Il contient le script, les exports bruts des deux recherches — celle du test et celle avec les réglages habituels —, les commandes exactes, les dates d’exécution et les versions des outils. Vous pouvez recalculer les chiffres directement à partir des exports.
L’exécution consomme environ deux pour cent du quota mensuel. Si les résultats obtenus avec votre compte diffèrent des nôtres, écrivez-nous : nous examinerons et expliquerons publiquement l’écart, comme l’auteur l’a fait pour son test.
Bilan
Cinq conclusions du test face à notre vérification
| Conclusion de l’étude | Résultat de la vérification | Point |
|---|---|---|
| MCP : 0 sur 8 et 179 secondes | 43 appels réussis sur 43, 1,6 s en moyenne ; les deux lignes décrivent le même serveur | point 6 |
| Cent fiches, 55 fichiers distincts | Même résultat avec ce tri ; 100 sur 100 avec le filtre d’unicité | point 4 |
| Les bases se recoupent à peine | Seules les premières centaines étaient comparées, soit 0,4 % du volume hebdomadaire ; après contrôle perceptuel, 98,1 % de nos fichiers n’y figuraient pas ailleurs | point 5 |
| Spytrend a trouvé 996 annonces en un jour | C’est ce que l’agent a sorti ; la base en contenait 3 112 à cette date, puis 4 072 | point 2 |
| Cinq cases manquent à Spytrend dans la grille | Dans le test (août 2026), seule Spytrend est indiquée pour la similarité visuelle de la créa et le pixel ; le lien de tracking et le réseau de webmaster ne figurent pas dans la grille du test | point 1 |
En résumé, trois conditions de collecte ont pesé sur le résultat : un tri fondé sur une métrique indisponible pour les publicités commerciales, un filtre d’unicité désactivé et une comparaison de versions de fichiers par hash. L’agent n’a pas accédé à une grande partie des fonctions déjà présentes dans Spytrend. En reprenant les mêmes fiches avec ces réglages corrigés, nous obtenons 23 986 annonces pertinentes sur la semaine, contre 6 438 pour le plus proche des quatre autres services — les deux chiffres datent du test —, 100 créas distinctes sur 100 et 43 appels MCP réussis sur 43.
Vous pouvez le vérifier sans nous croire sur parole. Prenez le script, vos clés et une combinaison de créa, page et domaine à examiner : l’exécution prend cinq minutes. Si les chiffres diffèrent, nous examinerons publiquement l’écart.
Consultez la base gratuitement : l’offre gratuite Starter donne accès sans carte bancaire, en mode limité, aux archives d’annonces datant de plus de 90 jours — spytrend.com.
Spytrend est une plateforme de veille concurrentielle sur les publicités Facebook et TikTok. Elle rassemble une base d’annonces depuis 2018 (la majeure partie date de 2025–2026), classées par IA dans 33 catégories d’activité, et regroupe chaque annonceur sur une fiche : toutes ses annonces, pages, domaines et pays au même endroit.
Environ 1,8 milliard d’annonces, environ 280 millions de nouvelles annonces par mois, 342 sous-catégories et un serveur MCP officiel pour Claude, ChatGPT, Cursor et Codex.
Les graphiques de l’étude sont reproduits comme citations à des fins de comparaison ; leurs droits appartiennent à l’auteur. Notre vérification repose sur ses fiches, les journaux du serveur et une nouvelle collecte.